데이터 모델링에는 개념, 논리, 물리라는 세 단계가 있습니다. 같은 데이터베이스를 왜 세 번이나 그리는지 처음에는 의아하지만, 단계마다 결정하는 것이 다릅니다. 개념 단계에서는 무엇을 관리할지, 논리 단계에서는 그것을 어떤 속성과 키로 표현할지, 물리 단계에서는 어떤 DBMS에 어떤 자료형으로 만들지를 정합니다.
게시판을 개념 ERD, 논리 ERD, 물리 ERD로 차례로 옮기면 단계마다 추가되는 정보가 분명해집니다. 뒤에는 SQLD 1과목에서 구분해야 할 항목도 함께 정리했습니다.
데이터 모델링 단계를 셋으로 나누는 이유
설계를 한 번에 끝내지 않고 나누는 이유는, 각 단계에서 확정해야 하는 것과 아직 정하지 않아도 되는 것이 다르기 때문입니다.
기획 회의 자리에서 VARCHAR 길이를 이야기하면 대화가 진행되지 않습니다. 반대로 개발 직전까지 어떤 데이터를 관리할지 합의되지 않았다면 자료형을 아무리 잘 잡아도 다시 그리게 됩니다. 단계를 나눈다는 건 지금 결정할 것과 나중에 결정할 것을 갈라 두는 일입니다.
한 가지 더, 각 단계는 읽는 사람이 다릅니다. 개념 모델은 기획자와 현업이 함께 보고, 논리 모델은 설계 리뷰에서 개발자들이 보며, 물리 모델은 DBA와 개발자가 실제로 만들 때 봅니다. 그래서 개념 모델에 인덱스를 그려 넣으면 정작 봐야 할 사람이 읽지 못하는 문서가 됩니다.
개념 ERD: 무엇을 관리할 것인가
개념적 설계는 어떤 개체를 관리하고 개체 사이에 어떤 관계가 있는지 정하는 데 초점을 둡니다.
게시판이라면 회원, 게시글, 댓글 세 개가 개체가 되고, 회원이 게시글을 쓰고 게시글에 댓글이 달린다는 관계가 그려집니다. 이 단계의 그림은 박스 세 개와 선 두 개면 충분합니다.
이 글에서 사용하는 간략한 개념 ERD는 컬럼과 기본키를 생략하고 자료형도 표시하지 않습니다. 다만 방법론과 조직에 따라 핵심 속성이나 식별자를 개념 모델에 일부 표시하기도 하므로, 속성이 있으면 개념 모델이 아니라는 식으로 구분할 수는 없습니다. 개체 이름은 members가 아니라 회원처럼 업무에서 사용하는 용어로 작성합니다. 현업과 마주 앉아 "우리가 관리해야 할 대상이 이게 전부인가요"를 확인하는 자리가 개념 모델링입니다.
이 단계에서 자주 놓치는 것은 개체와 속성의 구분입니다. 카테고리를 게시글의 속성으로 볼 것인지 별도 개체로 볼 것인지 같은 판단인데, 카테고리에 이름 말고도 관리할 정보가 붙는다면 개체로 올려야 합니다. 이 판단이 헷갈릴 때는 ERD 그리는 법의 개체 선정 기준을 먼저 보시면 도움이 됩니다.
논리 ERD: 속성과 키가 들어오는 단계
논리적 설계로 넘어오면 각 개체에 속성이 붙습니다. 회원에는 이메일, 닉네임, 가입일이 들어가고, 게시글에는 제목, 본문, 작성일이 들어갑니다. 그리고 각 개체에서 행을 하나로 식별할 수 있는 식별자를 정합니다.
관계도 이 단계에서 구체화됩니다. 회원과 게시글이 그냥 연결되는 게 아니라 1:N인지 N:M인지, 필수인지 선택인지가 정해집니다. 게시글은 반드시 작성자가 있어야 하므로 게시글 쪽에서 회원은 필수이고, 회원은 게시글을 한 건도 작성하지 않을 수 있으니 회원 쪽에서 게시글은 선택입니다.
정규화도 논리 단계의 일입니다. 게시글 테이블에 카테고리 이름을 그대로 넣어 두면 카테고리명을 바꿀 때 게시글을 전부 수정하게 되므로, 카테고리를 분리하고 참조로 바꿉니다. 어떤 구조를 왜 분리하는지는 데이터베이스 정규화에 1정규형부터 3정규형까지 예제로 정리해 두었습니다.
식별 관계와 비식별 관계도 논리 모델에서 정합니다. 부모의 키가 자식의 기본키 일부가 되면 식별 관계, 일반 외래 키 컬럼으로만 들어가면 비식별 관계입니다. 게시글의 태그처럼 두 키를 묶어 기본키로 사용하는 경우가 식별 관계에 해당하고, 실무에서 만나는 대부분의 관계는 비식별입니다.
논리 ERD까지 오면 특정 DBMS를 정하지 않은 상태에서도 설계 리뷰를 할 수 있습니다. 아직 이름은 회원, 이메일처럼 논리명이고, 자료형도 문자, 숫자, 날짜 정도로만 잡혀 있습니다.
물리 ERD: 자료형과 인덱스가 정해지는 단계
물리적 설계는 DBMS를 정하고 시작합니다. MySQL로 간다면 여기서부터 이름이 members, posts가 되고, 이메일은 VARCHAR(255), 작성일은 DATETIME이 됩니다.
이 단계에서 추가되는 것은 대략 이렇습니다.
- 실제 테이블명과 컬럼명. 팀의 명명 규칙을 적용해 물리명을 확정합니다.
- 자료형과 길이. 문자 대신 VARCHAR(200), 숫자 대신 BIGINT처럼 DBMS의 실제 타입을 지정합니다.
- 인덱스. 조회 조건으로 사용하는 컬럼에 인덱스를 설계합니다.
- 제약 조건. NOT NULL, UNIQUE, 기본값, 외래 키의 삭제 규칙을 정합니다.
- 성능을 위한 조정. 필요하다면 반정규화를 여기서 판단합니다.
물리 ERD는 DDL과 거의 1:1로 맞아떨어집니다. 위의 게시판을 MySQL 기준으로 옮기면 이런 모습이 됩니다.
CREATE TABLE members (
  id         BIGINT AUTO_INCREMENT PRIMARY KEY,
  email      VARCHAR(255) NOT NULL UNIQUE COMMENT '이메일',
  nickname   VARCHAR(50)  NOT NULL COMMENT '닉네임',
  created_at DATETIME     NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '가입일'
) COMMENT='회원';

CREATE TABLE posts (
  id          BIGINT AUTO_INCREMENT PRIMARY KEY,
  member_id   BIGINT       NOT NULL COMMENT '작성자',
  category_id INT          NOT NULL COMMENT '카테고리',
  title       VARCHAR(200) NOT NULL COMMENT '제목',
  content     TEXT         NULL COMMENT '본문',
  created_at  DATETIME     NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '작성일',
  CONSTRAINT fk_posts_member FOREIGN KEY (member_id) REFERENCES members (id),
  INDEX idx_posts_member_created (member_id, created_at)
) COMMENT='게시글';
논리 단계의 이메일이 VARCHAR(255) NOT NULL UNIQUE가 되고, 작성자별 최신 글 조회를 위한 인덱스가 붙었습니다. 논리 모델에는 없던 결정입니다.
논리에서 물리로 넘어갈 때 확인할 것
논리 모델이 끝났다고 바로 DDL을 쓰기 시작하면, 테이블마다 다른 규칙이 섞여 들어갑니다. 넘어가기 전에 팀에서 먼저 맞춰 두면 좋은 항목이 몇 가지 있습니다.
- 명명 규칙. 테이블 이름을 단수로 할지 복수로 할지, 축약어를 어디까지 허용할지 정해 둡니다. 이 결정이 늦으면 member 테이블과 users 테이블이 한 스키마에 공존하게 됩니다.
- 자료형 매핑. 논리 모델의 문자, 숫자, 날짜를 각각 어떤 타입으로 옮길지 표로 만들어 둡니다. 금액을 FLOAT으로 잡았다가 소수점 오차로 정산이 어긋나는 문제가 여기서 갈립니다.
- 식별자 전략. 업무에서 사용하는 값을 기본키로 할지, 별도의 일련번호를 둘지 정합니다. 사업자번호나 이메일처럼 바뀔 수 있는 값을 기본키로 두면 나중에 참조하는 테이블까지 함께 손봐야 합니다.
- 공통 컬럼. 생성일, 수정일, 작성자 같은 컬럼을 모든 테이블에 둘지, 어떤 이름으로 통일할지 미리 정합니다.
- 삭제 규칙. 외래 키에 삭제 제한을 걸지, 연쇄 삭제를 허용할지 결정합니다. 회원 탈퇴 시 게시글을 어떻게 처리할지 같은 업무 규칙이 여기에 반영됩니다.
이 다섯 가지를 먼저 정리해 두면 물리 모델을 그리는 속도가 빨라지고, 나중에 테이블마다 규칙이 달라 생기는 수정도 줄어듭니다.
개념·논리·물리 ERD 차이 한눈에 보기
세 단계를 표로 놓으면 차이가 분명해집니다.
| 구분 | 개념 ERD | 논리 ERD | 물리 ERD |
|---|---|---|---|
| 답하는 질문 | 무엇을 관리하나 | 어떻게 표현하나 | 어디에 어떻게 만드나 |
| 이름 | 업무 용어(회원) | 논리명(회원, 이메일) | 물리명(members, email) |
| 속성 | 생략하거나 핵심만 표시 | 주요 속성과 식별자 | 전체 컬럼과 자료형 |
| 관계 | 있다·없다 수준 | 차수와 필수 여부까지 | 외래 키와 삭제 규칙 |
| DBMS | 무관 | 무관 | 확정 |
| 주 독자 | 기획·현업 | 설계자·개발자 | 개발자·DBA |
같은 게시판을 세 단계로 그리면 이렇게 변해 갑니다.
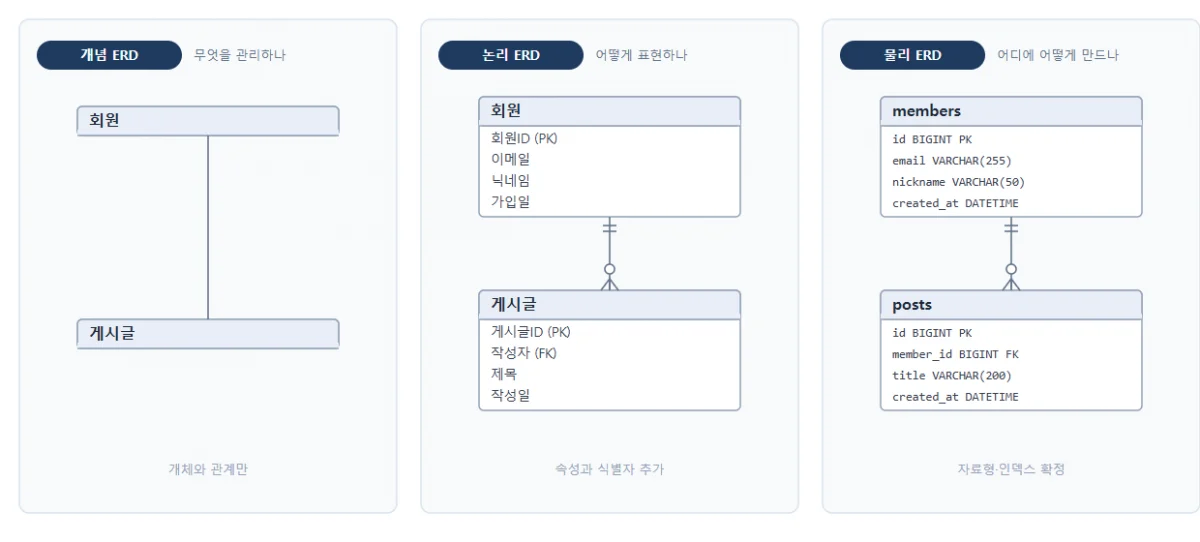
박스 안이 채워지는 순서를 보면 세 단계의 성격이 그대로 드러납니다. 개념에서는 이름만, 논리에서는 속성과 키, 물리에서는 자료형과 제약까지 들어갑니다. 관계선의 기호도 논리 단계부터 의미가 붙는데, 기호 읽는 법은 ERD 표기법 총정리에 정리해 두었습니다.
3층 스키마 구조와 헷갈리지 않기
개념·논리·물리 세 단계와, 외부 스키마·개념 스키마·내부 스키마로 나누는 3층 스키마 구조는 이름이 비슷해서 자주 섞입니다. 서로 다른 이야기입니다.
3층 스키마는 데이터베이스를 어떻게 구성해서 보여줄지 정한 구조입니다. 사용자마다 다르게 보이는 뷰가 외부 스키마, 전체 논리 구조가 개념 스키마, 실제 저장 방식이 내부 스키마입니다. 반면 이 글에서 다루는 개념·논리·물리는 설계를 진행하는 공정의 구분입니다.
이름이 겹치는 부분이 있어 대응 관계를 억지로 외우려는 경우가 있는데, 시험에서도 둘은 각각 따로 출제됩니다. 3층 스키마는 구조, 개념·논리·물리는 공정으로 갈라 두면 헷갈리지 않습니다.
실무에서는 어디까지 나누나
세 단계를 모두 문서로 남기는 곳도 있고, 두 단계를 합치는 곳도 있습니다.
공공 사업이나 대형 SI에서는 산출물 목록에 개념 모델, 논리 모델, 물리 모델이 각각 들어가 있는 경우가 많습니다. 검수 항목이라 순서대로 만들고 승인을 받습니다.
반대로 소규모 팀에서는 개념 모델을 회의실 화이트보드로 대신하고, 논리와 물리를 한 장에 합쳐 그리는 방식이 흔합니다. DBMS가 이미 정해져 있으니 논리명과 물리명을 따로 관리할 이유가 크지 않기 때문입니다.
어느 쪽이든 순서 자체는 지키는 게 좋습니다. 관리할 대상을 정하고, 속성과 키를 정하고, 자료형을 정하는 흐름을 건너뛰면 자료형부터 잡고 업무를 거기에 맞추게 됩니다. 문서를 세 개 만들지 않더라도 질문 세 개는 순서대로 짚고 넘어가면 됩니다.
SQLD 1과목 대비 요점
SQLD는 두 과목으로 나뉩니다. 1과목 데이터 모델링의 이해가 10문항 20점, 2과목 SQL 기본 및 활용이 40문항 80점으로 전체 50문항이고 시험 시간은 90분입니다. 총점 60점 이상이면 합격이지만 과목별 40% 미만은 과락이라, 1과목에서 최소 8점은 확보해야 합니다. 문항 수는 적어도 버릴 수 없는 과목입니다.
1과목은 크게 데이터 모델링의 이해와 데이터 모델과 성능으로 나뉘고, 이 글의 내용은 앞쪽에 해당합니다. 자주 나오는 항목은 다음과 같습니다.
세 단계의 구분. 개념, 논리, 물리 중 어느 단계에서 무엇을 결정하는지를 묻습니다. 자료형과 인덱스는 물리, 정규화와 식별자는 논리, 개체와 관계 정의는 개념으로 정리해 두면 대부분 풀립니다.
엔터티와 속성, 관계. 엔터티가 되기 위한 조건, 속성의 종류, 관계의 차수와 선택성을 구분하는 문제가 나옵니다. 선택성은 필수인지 선택인지를 가리키는 말로, ERD에서는 관계선 끝의 기호로 표현됩니다.
식별자. 주식별자와 보조식별자, 내부식별자와 외부식별자, 단일식별자와 복합식별자를 구분해 두어야 합니다. 주식별자의 조건인 유일성, 최소성, 불변성, 존재성도 자주 나오는 항목입니다.
식별 관계와 비식별 관계. 부모의 키가 자식의 주식별자에 포함되면 식별 관계이고 실선으로, 일반 속성으로 들어가면 비식별 관계이고 점선으로 표기합니다. SQLD 표기법 문제에서 실선과 점선의 의미를 묻는 방식으로 나옵니다.
정규화와 반정규화. 1정규형부터 3정규형까지의 정의와 각각이 해결하는 이상 현상, 반정규화를 언제 하는지를 묻습니다. 이 부분은 데이터베이스 정규화에 예제와 함께 정리해 두었습니다.
자주 틀리는 세 가지
첫 번째는 단계와 산출물을 뒤집어 보는 경우입니다. 정규화를 물리 설계로, 인덱스를 논리 설계로 답하기 쉬운데, 정규화는 논리, 인덱스는 물리입니다.
두 번째는 관계선의 실선과 점선을 반대로 외우는 경우입니다. 실선이 식별 관계, 점선이 비식별 관계입니다.
세 번째는 주식별자 조건에서 최소성을 빠뜨리는 경우입니다. 유일하기만 하면 되는 게 아니라 필요한 최소한의 속성으로 구성되어야 합니다.
자주 묻는 질문
개념·논리·물리 ERD 차이를 한 줄로 설명하면?
무엇을 관리할지 정하는 게 개념, 그것을 어떤 속성과 키로 표현할지 정하는 게 논리, 어떤 DBMS에 어떤 자료형으로 만들지 정하는 게 물리입니다. 같은 업무를 단계마다 더 구체적으로 정리해 나가는 과정이라, 뒤로 갈수록 그림에 정보가 늘어납니다.
논리 ERD와 물리 ERD는 정확히 무엇이 다른가요?
논리 ERD는 DBMS를 정하지 않은 상태의 설계이고, 물리 ERD는 DBMS를 정한 뒤의 설계입니다. 논리 단계에서는 회원, 이메일처럼 업무 용어와 논리명을 사용하고 자료형은 문자, 숫자, 날짜 수준으로만 잡습니다. 물리 단계에서 members, VARCHAR(255)처럼 실제 이름과 자료형, 인덱스, 제약이 붙어 DDL과 1:1로 맞아떨어집니다.
SQLD에서 데이터 모델링은 몇 문제나 나오나요?
1과목 데이터 모델링의 이해가 10문항 20점입니다. 2과목 SQL 기본 및 활용이 40문항 80점이라 전체 50문항 100점이고, 시험 시간은 90분입니다. 총점 60점 이상이면 합격이지만 과목별로 40% 미만이면 과락이라, 1과목에서 8점은 확보해야 합니다.
실무에서도 세 단계를 다 그리나요?
프로젝트 규모에 따라 다릅니다. 공공 사업이나 대형 SI처럼 산출물 목록이 정해진 곳에서는 세 단계를 모두 문서로 남기고, 소규모 팀에서는 개념 모델을 화이트보드로 대신하고 논리와 물리를 한 장에 합쳐 그리는 경우가 흔합니다. 다만 단계를 합치더라도 각 단계가 답하는 질문은 순서대로 짚고 넘어가야 설계가 흔들리지 않습니다.
개념은 관리 대상을, 논리는 표현 방법을, 물리는 구현 환경을 정합니다. 시험에서는 결정 항목과 단계를 연결해서 기억하고, 실무에서는 이 순서대로 설계를 구체화하면 됩니다.
물리 모델까지 확정했다면 DDL을 WorksCove ERD에 붙여넣어 다이어그램과 테이블 명세서를 만드는 방법도 있습니다. 반대로 이미 만들어진 DB의 구조부터 확인해야 한다면 SQL을 ERD로 변환하기를 먼저 보시면 됩니다.