データモデリングは、概念・論理・物理の三段階に分けられます。概念では管理対象、論理では属性とキーによる表現、物理では対象DBMSと実際のデータ型を決めます。
掲示板を概念モデル・論理モデル・物理モデルへ順に落とし込み、各段階で増える情報を比較します。後半では試験で問われる区分と3層スキーマとの違いも扱います。
データモデリングを三段階に分ける理由
設計を一度で終わらせずに分けるのは、それぞれの段階で確定させるものと、まだ決めなくてよいものが違うからです。
企画の打ち合わせでVARCHARの桁数を話し始めても議論は進みません。逆に、開発の直前まで何のデータを管理するのかが合意できていなければ、データ型をいくら丁寧に決めても描き直しになります。段階を分けるというのは、いま決めることと後で決めることを仕分けておく作業です。
もう一つ、段階ごとに読む人が違います。概念モデルは企画担当や業務部門と一緒に見るもの、論理モデルは設計レビューで開発者が見るもの、物理モデルはDBAと開発者が実際に作るときに見るものです。概念モデルにインデックスまで描き込むと、本来読むべき人が読めない資料になってしまいます。
概念モデル:何を管理するのか
概念設計では、どんなエンティティを管理し、エンティティ同士にどんな関係があるのかに焦点を当てます。
掲示板なら、会員・投稿・コメントの三つがエンティティになり、会員が投稿を書き、投稿にコメントが付くという関係が描かれます。この段階の図は、四角が三つと線が二本あれば足ります。
この記事で使う簡略な概念データモデルでは、カラム一覧と主キーを省略し、データ型も表示しません。ただし、方法論や組織によっては主要な属性や識別子をこの段階で一部示すこともあるため、属性があれば概念モデルではないとは言い切れません。エンティティ名はmembersではなく「会員」のように業務で使う言葉で書きます。業務部門と向かい合って、管理すべき対象はこれで全部か、を確認する場が概念モデリングです。
この段階でよくつまずくのが、エンティティと属性の切り分けです。カテゴリを投稿の属性と見るか、独立したエンティティと見るかという判断で、カテゴリに名前以外の管理項目が付くならエンティティに上げます。この判断に迷ったときは、ER図の書き方のエンティティの選び方から読むと整理しやすくなります。
論理モデル:属性とキーが入ってくる段階
論理設計に入ると、各エンティティに属性が付きます。会員にはメールアドレス、ニックネーム、登録日。投稿にはタイトル、本文、投稿日。そして各エンティティで行を一意に識別できる識別子を決めます。
関係もこの段階で具体化します。会員と投稿がただつながるのではなく、1対Nなのか多対多なのか、必須なのか任意なのかまで決まります。投稿には必ず作成者がいるので、投稿から見た会員は必須、会員は投稿を一件も書かないこともあるので、会員から見た投稿は任意です。
正規化も論理段階の仕事です。投稿テーブルにカテゴリ名をそのまま持たせると、カテゴリ名を変えるたびに投稿を全部更新することになるので、カテゴリを分離して参照に変えます。どんな構造をなぜ分けるのかは、データベース正規化に第1正規形から第3正規形まで例つきでまとめてあります。
識別関係と非識別関係も論理モデルで決めます。親のキーが子の主キーの一部になれば識別関係、通常の外部キーのカラムとして入るだけなら非識別関係です。投稿とタグを結ぶ中間テーブルのように二つのキーを組んで主キーにする形が識別関係にあたり、実務で出会う関係の多くは非識別です。
論理モデルまで来ると、DBMSを決めていない状態でも設計レビューができます。名前はまだ「会員」「メールアドレス」のような論理名で、データ型も文字・数値・日付くらいの粒度です。
物理モデル:データ型とインデックスが決まる段階
物理設計はDBMSを決めてから始めます。MySQLで行くなら、ここから名前がmembers、postsになり、メールアドレスはVARCHAR(255)、投稿日はDATETIMEになります。
この段階で足されるのは、だいたい次のものです。
- 実際のテーブル名とカラム名。 チームの命名規則を適用して物理名を確定します。
- データ型と桁数。 文字ではなくVARCHAR(200)、数値ではなくBIGINTのように、DBMSの実際の型を指定します。
- インデックス。 検索条件に使うカラムへインデックスを設計します。
- 制約。 NOT NULL、UNIQUE、デフォルト値、外部キーの削除規則を決めます。
- 性能のための調整。 必要なら非正規化をここで判断します。
物理モデルはDDLとほぼ1対1で対応します。上の掲示板をMySQLに落とすと、こうなります。
CREATE TABLE members (
  id         BIGINT AUTO_INCREMENT PRIMARY KEY,
  email      VARCHAR(255) NOT NULL UNIQUE COMMENT 'メールアドレス',
  nickname   VARCHAR(50)  NOT NULL COMMENT 'ニックネーム',
  created_at DATETIME     NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '登録日'
) COMMENT='会員';

CREATE TABLE posts (
  id          BIGINT AUTO_INCREMENT PRIMARY KEY,
  member_id   BIGINT       NOT NULL COMMENT '作成者',
  category_id INT          NOT NULL COMMENT 'カテゴリ',
  title       VARCHAR(200) NOT NULL COMMENT 'タイトル',
  content     TEXT         NULL COMMENT '本文',
  created_at  DATETIME     NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '投稿日',
  CONSTRAINT fk_posts_member FOREIGN KEY (member_id) REFERENCES members (id),
  INDEX idx_posts_member_created (member_id, created_at)
) COMMENT='投稿';
論理段階のメールアドレスがVARCHAR(255) NOT NULL UNIQUEになり、作成者ごとの新着一覧のためのインデックスが付きました。論理モデルにはなかった決定です。
論理から物理へ移る前に決めておくこと
論理モデルが終わったからといってすぐDDLを書き始めると、テーブルごとに違う規則が混ざり込みます。移る前にチームで揃えておきたい項目がいくつかあります。
- 命名規則。 テーブル名を単数にするか複数にするか、略語をどこまで許すかを決めておきます。ここが遅れると、memberテーブルとusersテーブルが同じスキーマに同居することになります。
- データ型の対応。 論理モデルの文字・数値・日付を、それぞれどの型に落とすかを表にしておきます。金額をFLOATにして小数の誤差で精算が合わなくなる問題は、ここで分かれます。
- 識別子の方針。 業務で使う値を主キーにするか、別に連番を持つかを決めます。法人番号やメールアドレスのように変わりうる値を主キーにすると、あとで参照側のテーブルまで直すことになります。
- 共通カラム。 作成日時、更新日時、作成者のようなカラムを全テーブルに置くのか、どの名前で統一するのかを先に決めます。
- 削除の規則。 外部キーに削除制限をかけるのか、連鎖削除を許すのか。退会時に投稿をどう扱うかといった業務ルールがここに反映されます。
この五つを先に整理しておくと物理モデルを描く速度が上がり、あとからテーブルごとの規則の違いを直す作業も減ります。
概念・論理・物理の違いを一覧で
三段階を表に並べると違いがはっきりします。
| 項目 | 概念モデル | 論理モデル | 物理モデル |
|---|---|---|---|
| 答える問い | 何を管理するか | どう表すか | どこにどう作るか |
| 名前 | 業務用語(会員) | 論理名(会員、メールアドレス) | 物理名(members、email) |
| 属性 | 省略または主要な概念だけ | 主要な属性と識別子 | 全カラムとデータ型 |
| 関係 | ある・ないの水準 | 多重度と必須・任意まで | 外部キーと削除規則 |
| DBMS | 関係なし | 関係なし | 確定 |
| 主な読み手 | 企画・業務部門 | 設計者・開発者 | 開発者・DBA |
同じ掲示板を三段階で描くと、こう変わっていきます。
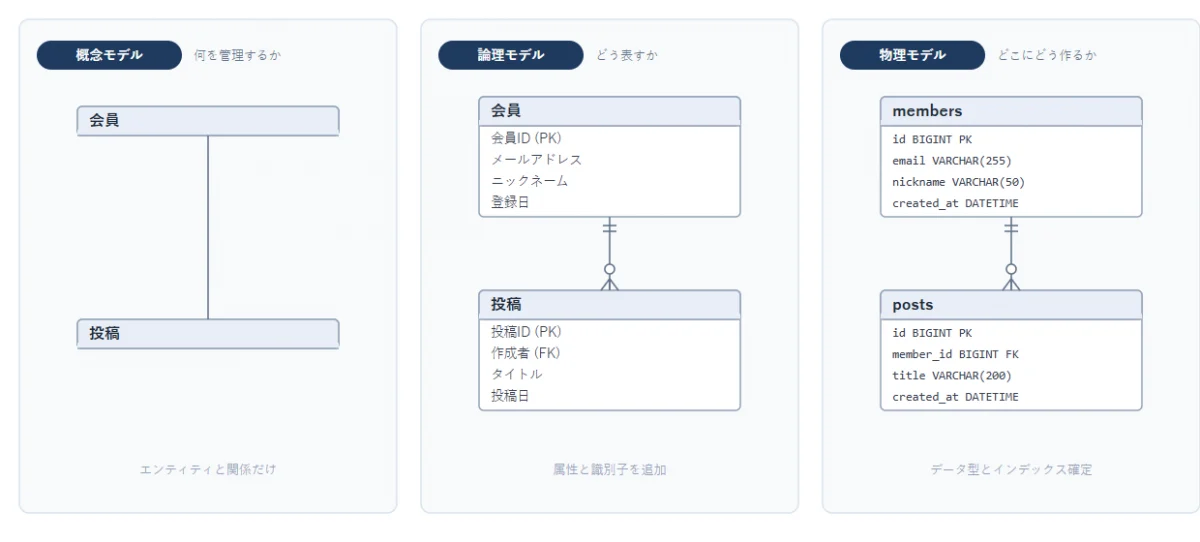
四角の中が埋まっていく順番に、三段階の性格がそのまま出ています。概念では名前だけ、論理では属性とキー、物理ではデータ型と制約まで入ります。関係線の記号も論理段階から意味を持ちはじめるので、記号の読み方はER図の記号まとめにまとめてあります。
3層スキーマとの違い
概念・論理・物理の三段階と、外部スキーマ・概念スキーマ・内部スキーマの3層スキーマは、名前が似ているので混同されがちですが別の話です。
3層スキーマはANSI/SPARCが示したデータベースの構成の考え方で、利用者ごとの見え方(外部)、全体の論理構造(概念)、格納方法(内部)という三つの層に分けます。一方この記事の概念・論理・物理は、設計を進める工程の分け方です。層の名前と工程の名前がたまたま重なっているだけで、対応関係を無理に覚える必要はありません。
実務ではどこまで分けるのか
三段階すべてを資料として残す現場もあれば、二つをまとめる現場もあります。
官公庁や大規模なSIでは、成果物の一覧に概念モデル・論理モデル・物理モデルがそれぞれ入っていることが多く、検収の項目になっているので順番に作って承認をもらいます。
反対に少人数のチームでは、概念モデルは会議室のホワイトボードで済ませ、論理と物理を一枚にまとめて描くやり方が一般的です。DBMSがすでに決まっているので、論理名と物理名を別々に管理する理由が大きくないからです。
どちらにしても、順番そのものは守るほうがよいです。管理する対象を決め、属性とキーを決め、データ型を決めるという流れを飛ばすと、データ型から先に決めて業務をそこに合わせることになります。資料を三つ作らなくても、問いを三つ順番に確認すれば十分です。
試験でよく問われる観点
基本情報技術者試験やデータベーススペシャリスト試験でも、この三段階は繰り返し出てきます。押さえておくと迷わない箇所を挙げておきます。
どの段階で何を決めるか。 データ型とインデックスは物理、正規化と識別子は論理、エンティティと関係の定義は概念。この対応で大半の設問は整理できます。
エンティティ・属性・関係。 エンティティとして扱う条件、属性の種類、関係の多重度と必須・任意の区別が問われます。多重度はER図では線の端の記号として表れます。
識別子。 主識別子と候補キー、単一キーと複合キーの区別、そして主識別子の条件(一意性・最小性・不変性・存在)を押さえておきます。
識別関係と非識別関係。 親のキーが子の主キーに含まれるのが識別関係で実線、通常の属性として入るのが非識別関係で破線です。表記の意味を問う設問でそのまま出ます。
正規化と非正規化。 第1〜第3正規形の定義と、それぞれが防ぐ更新時の不整合、そして非正規化をいつ選ぶのか。この範囲はデータベース正規化に例つきでまとめてあります。
間違えやすい三つ
一つめは、工程と成果物を逆に覚えてしまうことです。正規化を物理設計、インデックスを論理設計と答えがちですが、正規化は論理、インデックスは物理です。
二つめは、関係線の実線と破線を反対に覚えることです。実線が識別関係、破線が非識別関係です。
三つめは、主識別子の条件から最小性が抜け落ちることです。一意でありさえすればよいのではなく、必要最小限の属性で構成されている必要があります。
よくある質問
概念・論理・物理モデルの違いを一言でいうと?
何を管理するのかを決めるのが概念、それをどんな属性とキーで表すのかを決めるのが論理、どのDBMSにどんなデータ型で作るのかを決めるのが物理です。同じ業務を段階的に具体化していく作業なので、後ろの段階ほど図に載る情報が増えます。
論理モデルと物理モデルは具体的に何が違いますか?
論理モデルはDBMSを決めていない状態の設計、物理モデルはDBMSを決めたあとの設計です。論理では「会員」「メールアドレス」のような論理名を使い、データ型も文字・数値・日付程度にとどめます。物理ではmembers、VARCHAR(255)のように実際の名前とデータ型、インデックス、制約が付き、DDLとほぼ1対1で対応します。
概念データモデルとER図は同じものですか?
概念データモデルはER図で表現されることが多いので、実務では同じ図として扱われます。厳密には概念データモデルが「何を管理するか」というモデルそのもので、ER図はそれを描くための表記の一つです。同じER図の書式で概念・論理・物理のどの段階も描けます。
実務でも三段階すべてを作りますか?
プロジェクトの規模によります。官公庁や大規模なSIのように成果物が決まっている現場では三段階を別々の資料として残しますが、少人数のチームでは概念モデルをホワイトボードで済ませ、論理と物理を一枚にまとめて描くことも多いです。ただし資料をまとめる場合でも、各段階が答える問いは順番に確認しておくほうが設計が安定します。
概念モデルは管理対象、論理モデルは構造、物理モデルは実装を決めます。試験では決定項目と段階を対応させ、実務ではこの順番で設計を具体化します。
物理モデルまで固まっているなら、DDLをWorksCove ERDに貼り付けてダイアグラムとテーブル定義書を作る方法もあります。逆に、すでにあるDBの構造から確認したい場合はSQLからER図を自動生成するから読むとつながりがよいはずです。