"ERD 그려주는 AI 없나?" 싶다면 ChatGPT나 Claude부터 써 보면 됩니다. 서비스 설명을 주면 스키마 초안을 만들어 줍니다. 다만 요령이 하나 있는데, 그림을 그려 달라고 하지 말고 DDL(CREATE TABLE 문)로 달라고 해야 합니다.
독서 모임 요구사항을 예로 DDL 프롬프트를 작성하고, 받은 결과를 다이어그램으로 바꾼 뒤 검증 경고를 하나씩 확인해 보겠습니다.
왜 그림이 아니라 DDL인가
AI에게 "ERD 그려줘"라고 하면 보통 셋 중 하나가 돌아옵니다. 이미지, Mermaid 코드, 아니면 표 형태의 설명입니다. 셋 다 보는 용도로는 그럴듯한데, 받은 다음이 막힙니다.
이미지는 컬럼 하나를 고치려 해도 다시 생성하는 수밖에 없습니다. Mermaid는 문서에 넣기엔 좋지만 자료형·제약 표현이 제한적이고, 이걸 실제 DB로 만들려면 결국 DDL을 직접 다시 작성하게 됩니다.
DDL로 받으면 이야기가 달라집니다. CREATE TABLE 문은 그 자체로 실행 가능한 산출물이고, ERD 도구에 붙여넣으면 다이어그램이 되고, 그대로 DB에 실행하면 실제 테이블이 됩니다. AI의 출력을 어디로든 이어갈 수 있는 형식이 DDL입니다.
잘 나오는 프롬프트의 조건
프롬프트에 따라 결과 차이가 큽니다. 막연하게 부탁하면 막연한 답이 옵니다.
독서 모임 관리 서비스를 만들려고 해.

- 회원이 독서 모임을 만들고 가입할 수 있다
- 모임마다 매달 책을 한 권씩 선정한다
- 회원은 읽은 책에 별점(1~5)과 독후감을 남긴다

이 요구사항으로 MySQL 스키마를 설계해 줘.

조건:
- CREATE TABLE 문으로만 답해 줘
- 모든 테이블과 컬럼에 COMMENT를 달아 줘
- FK 제약을 CONSTRAINT 구문으로 명시해 줘
- PK는 BIGINT AUTO_INCREMENT 대리키로
포인트는 세 가지입니다. 요구사항을 문장으로 나열하고(AI는 여기서 개체와 관계를 뽑습니다), 출력 형식을 DDL로 못 박고, COMMENT·FK·PK 같은 품질 조건을 명시하는 것. 특히 COMMENT 조건은 꼭 넣으세요. 이게 있어야 나중에 다이어그램과 명세서에서 컬럼 설명이 살아 있습니다.
DBMS도 반드시 지정해야 합니다. MySQL과 PostgreSQL은 자료형과 문법이 달라서, 지정하지 않으면 이도 저도 아닌 혼합 문법이 나오는 경우가 있습니다.
반대로 넣지 말아야 할 것도 있습니다. "완벽하게", "실무 수준으로" 같은 수식어는 결과에 거의 영향을 주지 않습니다. 그보다는 구체적인 업무 규칙 한 줄이 훨씬 효과적입니다. "탈퇴한 회원의 독후감은 남긴다" 한 문장이 들어가면 AI가 삭제 정책과 NULL 허용을 알아서 고민하기 시작합니다.
요구사항이 정리되어 있지 않다면 그것부터 AI와 대화로 만드는 것도 방법입니다. "독서 모임 서비스에 필요한 데이터가 뭐가 있을까?"로 시작해 목록을 함께 다듬은 다음, 위 형식으로 DDL을 요청하면 됩니다.
받은 DDL을 다이어그램으로
위 프롬프트로 받은 DDL의 앞부분은 이런 모양이었습니다.
CREATE TABLE members (
  id               BIGINT AUTO_INCREMENT PRIMARY KEY,
  email            VARCHAR(255) NOT NULL UNIQUE COMMENT '로그인 계정',
  nickname         VARCHAR(50)  NOT NULL COMMENT '닉네임',
  current_group_id BIGINT NULL COMMENT '현재 활동 모임',
  joined_at        DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '가입 시각'
) COMMENT='회원';

CREATE TABLE reading_groups (
  id         BIGINT AUTO_INCREMENT PRIMARY KEY,
  owner_id   BIGINT NOT NULL COMMENT '모임장',
  name       VARCHAR(100) NOT NULL COMMENT '모임 이름',
  created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '개설 시각',
  CONSTRAINT fk_groups_owner FOREIGN KEY (owner_id) REFERENCES members (id)
) COMMENT='독서 모임';
books, group_books, reviews까지 다섯 테이블, 첫눈에는 흠잡을 데 없어 보입니다. 이걸 WorksCove ERD의 SQL 스키마 가져오기에 붙여넣으면 관계선까지 연결된 다이어그램이 바로 만들어집니다. 텍스트로 볼 때는 안 보이던 구조가 눈에 들어오는 순간입니다. 그려진 관계선의 기호가 낯설다면 ERD 표기법 총정리를 참고하면 됩니다. 가져오기 과정 자체가 궁금하다면 SQL to ERD에서 화면과 함께 볼 수 있습니다.
가장 중요한 단계: AI 결과물 검증
AI가 만든 스키마는 비슷한 장단점을 보입니다. 개체와 기본 관계는 빠르게 잡지만, 운영 규칙이나 DBMS별 세부 조건은 빠뜨리기 쉽습니다.
위의 독서 모임 스키마를 자동 검증에 돌린 결과가 이렇습니다.
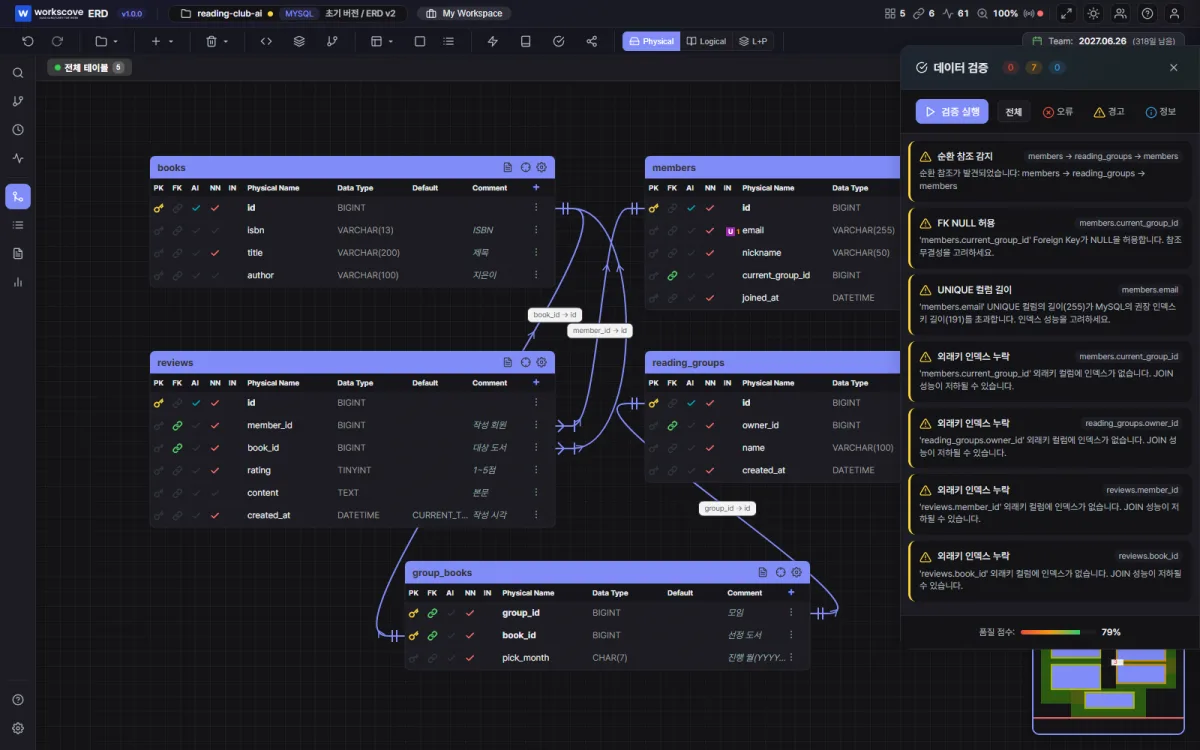
경고는 7건입니다. 다만 경고가 곧 오류라는 뜻은 아닙니다. 대상 DBMS와 실제 DDL을 보고 각각 판단해야 합니다.
순환 참조. members.current_group_id가 reading_groups를 가리키고, reading_groups.owner_id가 members를 가리킵니다. 이 예제는 current_group_id가 NULL 허용이라 회원을 먼저 넣고 모임을 만든 뒤 다시 갱신할 수 있으므로, 삽입 자체가 불가능한 구조는 아닙니다. 다만 "회원이 여러 모임에 가입한다"는 요구는 별도의 group_members 테이블로 표현해야 하고, 현재 모임을 따로 저장할지는 업무 규칙과 갱신 정합성을 보고 결정해야 합니다.
FK 인덱스 확인. 이 예제의 대상인 MySQL InnoDB는 필요한 인덱스가 없으면 FK 생성 시 참조하는 쪽 컬럼에 인덱스를 자동으로 만듭니다. 따라서 DDL에 별도 INDEX 문이 없다는 이유만으로 누락이라고 단정하면 안 됩니다. PostgreSQL처럼 FK 선언만으로 인덱스를 만들지 않는 DBMS도 있으므로, 대상 DBMS의 실제 인덱스와 조회 패턴을 함께 확인해야 합니다.
UNIQUE 컬럼 길이. MySQL의 "utf8mb4 인덱스는 191자까지"라는 제한은 767바이트 키 한도를 쓰는 오래된 InnoDB 행 형식에서 나온 이야기입니다. 현재 기본인 DYNAMIC 행 형식의 3,072바이트 한도에서는 VARCHAR(255)가 최대 1,020바이트라 UNIQUE 인덱스를 만들 수 있습니다. 서버 버전과 행 형식을 확인하지 않고 191자로 줄이는 것도 올바른 검증은 아닙니다.
이 세 가지 말고도, AI 스키마를 계속 받아 보면서 반복해서 마주친 유형이 몇 가지 더 있습니다.
- 업무 규칙이 필요한 제약을 임의로 정합니다. 별점 컬럼을
TINYINT로 잡는 것까진 좋은데 1~5 범위 제한은 빠져 있다거나, 반대로 묻지도 않은 CHECK 제약을 붙여 놓는 식입니다. 요구사항에 없던 결정이 슬그머니 들어와 있으니 한 줄씩 읽어 봐야 합니다. - 비슷한 컬럼의 자료형이 테이블마다 다릅니다. 한 테이블은
VARCHAR(50), 다른 테이블은VARCHAR(100)으로 같은 성격의 이름 컬럼이 제각각인 경우가 흔합니다. 사람이 하면 컨벤션으로 잡히는 부분인데, AI는 테이블 단위로 생성하다 보니 전체 일관성이 약합니다. - 삭제 정책이 통째로 빠져 있습니다. 이 MySQL 예제에서 ON DELETE를 생략하면 RESTRICT와 같은 거부 동작이 적용됩니다. 다른 DBMS는 기본 동작을 NO ACTION으로 부르기도 하고 세부 동작도 다를 수 있으므로, 이름을 뭉뚱그리기보다 대상 DBMS에서 부모 삭제가 어떻게 처리되는지 명시해야 합니다.
이런 항목을 눈으로 다 잡기는 어렵습니다. WorksCove ERD의 데이터 검증은 순환 참조, 인덱스 누락, 예약어 사용, 자료형 유효성 같은 25가지 항목을 자동 점검하고 품질 점수로 요약해 줍니다. AI에게 설계를 맡길수록 이 검증 단계의 가치가 커집니다. 초안 작성은 AI가 빨라졌지만, 초안을 믿어도 되는지 확인하는 일은 여전히 사람과 도구의 몫이기 때문입니다.
검증 경고를 AI에게 다시 물어보기
검증에서 나온 경고를 AI에게 다시 넘기면 루프가 완성됩니다. 실제로 위의 순환 참조 경고를 그대로 붙여 이렇게 요청했습니다.
이 스키마에서 members.current_group_id ↔ reading_groups 사이에
순환 참조가 있대. current_group_id 컬럼을 없애고
가입 이력을 별도 테이블로 풀어서 다시 설계해 줘.
돌아온 수정안이 이렇습니다.
CREATE TABLE group_members (
  group_id  BIGINT NOT NULL COMMENT '모임',
  member_id BIGINT NOT NULL COMMENT '회원',
  joined_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '가입 시각',
  PRIMARY KEY (group_id, member_id),
  CONSTRAINT fk_gm_group  FOREIGN KEY (group_id)  REFERENCES reading_groups (id),
  CONSTRAINT fk_gm_member FOREIGN KEY (member_id) REFERENCES members (id)
) COMMENT='모임 가입 이력';
순환이 사라졌을 뿐 아니라 "회원이 여러 모임에 가입할 수 있는가"라는, 원래 스키마가 얼버무렸던 질문에도 답이 생겼습니다. 수정된 DDL을 다시 가져오고 검증을 다시 돌리는 데 몇 분이면 됩니다. 설계 → 검증 → 수정의 반복이 사람끼리 할 때보다 훨씬 빨리 돌아갑니다.
Mermaid로 받고 싶다면
문서나 README에 끼워 넣을 다이어그램이 목적이라면 Mermaid로 받는 것도 방법입니다.
erDiagram
  MEMBERS ||--o{ REVIEWS : "작성"
  BOOKS   ||--o{ REVIEWS : "대상"
  READING_GROUPS ||--o{ GROUP_BOOKS : "선정"
마크다운 안에서 바로 렌더링되니 가볍게 공유하는 용도로는 충분합니다. 다만 자료형·인덱스·코멘트 같은 정보를 담기 어렵고, 여기서 실제 DB로 가려면 결국 DDL을 다시 만들어야 합니다. 그래서 순서를 바꾸는 쪽을 권합니다. DDL로 먼저 받아 두면, Mermaid가 필요할 때 DDL에서 변환하면 됩니다. 반대 방향은 정보가 부족해서 안 됩니다.
기존 DB가 있을 때 쓰는 프롬프트
새 서비스 설계만이 아니라, 이미 돌아가는 DB에도 AI를 붙일 수 있습니다. 이때는 현재 스키마를 재료로 주는 게 핵심입니다.
새 기능의 테이블 설계. 현재 스키마 DDL을 붙여 주고 "이 구조에 쿠폰 기능을 붙이려면 어떤 테이블이 필요할까? 기존 네이밍 규칙을 따라 줘"라고 하면, snake_case든 접두어든 기존 컨벤션에 맞춘 제안이 옵니다. 스키마 없이 물었을 때와 결과 품질이 완전히 다릅니다.
기존 구조 리뷰. "이 스키마에서 데이터가 쌓였을 때 문제가 될 지점을 짚어 줘"라고 하면 정규화나 인덱스 관점의 의견을 받을 수 있습니다. 다만 이건 어디까지나 의견이라, 위에서 말한 자동 검증과 병행해야 균형이 맞습니다.
현재 스키마의 DDL을 뽑는 방법이 막막하다면 SQL to ERD의 1단계에 DBMS별 명령을 모아 두었습니다. mysqldump 한 줄이면 됩니다.
정리: AI와 나누는 역할 분담
AI에게 시켜서 좋은 일과 사람이 챙겨야 하는 일을 나누면 이렇게 됩니다.
- AI에게: 요구사항에서 초안 스키마 뽑기, 검증 경고 반영해서 고치기, 기존 스키마에 새 기능 테이블 제안받기
- 사람과 도구가: 다이어그램으로 구조 확인, 자동 검증으로 결함 잡기, 업무 규칙(삭제 정책, NULL 허용)이 실제 요구와 맞는지 판단
ERD를 직접 그리는 순서가 필요하다면 ERD 그리는 법에서 개체와 관계를 정하는 단계부터 확인할 수 있습니다. AI는 초안 작성 시간을 줄여 주지만, 결과를 검토하고 수정하는 일까지 대신하지는 못합니다.
자주 묻는 질문
AI가 설계한 스키마를 그대로 써도 되나요?
초안으로는 훌륭하지만 그대로 운영에 올리는 건 권하지 않습니다. 관계 방향이나 정규화는 잘 잡는 반면, 순환 참조·인덱스 누락·자료형 선택처럼 운영에서 문제가 되는 지점은 자주 놓칩니다. 다이어그램으로 만들어 눈으로 확인하고, 자동 검증을 한 번 돌린 뒤에 쓰는 걸 권합니다.
어떤 AI가 ERD를 제일 잘 만드나요?
최근의 대화형 AI라면 이 정도 규모의 스키마 설계는 대부분 무리 없이 해냅니다. 모델 선택보다 요구사항을 얼마나 구체적으로 적는지, 출력 형식을 DDL로 못 박는지, 받은 결과를 검증하는지가 품질을 훨씬 크게 좌우합니다.
그림 파일이나 Mermaid로 받으면 안 되나요?
문서에 끼워 넣을 용도라면 Mermaid도 좋습니다. 다만 그림과 Mermaid는 받은 뒤에 편집하거나 명세서로 잇기 어렵습니다. DDL로 받으면 다이어그램 도구, DB, 문서 어디로든 이어지기 때문에 기본값은 DDL로 두는 게 활용 폭이 넓습니다.
기존 DB가 있는 경우에도 AI에게 시킬 일이 있나요?
새 기능의 테이블 추가 설계나 기존 구조 리뷰에 쓸 수 있습니다. 현재 스키마 DDL을 붙여 주고 ‘이 구조에 쿠폰 기능을 붙이려면 어떤 테이블이 필요할까’처럼 물으면, 기존 컨벤션에 맞춘 제안을 받을 수 있습니다.