AIでER図を作るなら、まずChatGPTやClaudeにサービスの説明を渡し、スキーマのたたき台を作ってもらいます。ただし、画像ではなくDDL(CREATE TABLE文)で受け取ることが重要です。
読書会サービスを例にDDLのプロンプトを作り、受け取ったスキーマをER図に変換して、検証結果を対象DBMSに照らして確認します。
なぜ絵ではなくDDLなのか
AIに「ER図を描いて」と頼むと、だいたい3つのどれかが返ってきます。画像、Mermaidコード、あるいは表形式の説明です。どれも見る分にはそれらしいのですが、受け取ったあとが行き詰まります。
画像はカラムひとつ直すにも作り直すしかありません。Mermaidはドキュメントに入れるには良いものの、型や制約の表現力が限られていて、これを実際のDBにするには結局手でDDLを書き直すことになります。
DDLで受け取ると話が変わります。CREATE TABLE文はそれ自体が実行可能な成果物で、ER図ツールに貼れば図になり、DBに流せば実テーブルになります。AIの出力をどこへでもつなげられる形式がDDLです。
良い結果が出るプロンプトの条件
プロンプト次第で結果は大きく変わります。漠然と頼めば、漠然とした答えが返ります。
読書会の運営サービスを作ろうとしています。

- 会員が読書グループを作成し、参加できる
- グループごとに毎月1冊、本を選定する
- 会員は読んだ本に評価(1〜5)とレビューを残す

この要件でMySQLのスキーマを設計してください。

条件:
- CREATE TABLE文だけで答えてください
- すべてのテーブルとカラムにCOMMENTを付けてください
- FK制約はCONSTRAINT構文で明示してください
- PKはBIGINT AUTO_INCREMENTの代理キーでポイントは3つです。要件を文章で並べる(AIはここから実体とリレーションを拾います)、出力形式をDDLに固定する、COMMENT・FK・PKといった品質条件を明示する。COMMENTの条件は特に入れてください。これがあるおかげで、あとで図や定義書にカラムの説明が残ります。
DBMSの指定も必須です。MySQLとPostgreSQLは型も文法も違うので、指定しないとどちらでも動かない混合文法が出てくることがあります。
逆に、入れなくていいものもあります。「完璧に」「実務レベルで」といった修飾語は結果にほとんど影響しません。それより具体的な業務ルール1行のほうがずっと効きます。「退会した会員のレビューは残す」の一文が入ると、AIは削除ポリシーとNULL許容を自分で考え始めます。
要件がまだ整理できていないなら、それ自体をAIとの対話で作るのも手です。「読書会サービスに必要なデータって何だろう?」から始めてリストを一緒に整え、そのあと上の形式でDDLを頼めばいいのです。
受け取ったDDLを図にする
上のプロンプトで返ってきたDDLの冒頭はこんな形でした。
CREATE TABLE members (
  id               BIGINT AUTO_INCREMENT PRIMARY KEY,
  email            VARCHAR(255) NOT NULL UNIQUE COMMENT 'ログインアカウント',
  nickname         VARCHAR(50)  NOT NULL COMMENT '表示名',
  current_group_id BIGINT NULL COMMENT '現在の参加グループ',
  joined_at        DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '登録日時'
) COMMENT='会員';

CREATE TABLE reading_groups (
  id         BIGINT AUTO_INCREMENT PRIMARY KEY,
  owner_id   BIGINT NOT NULL COMMENT 'グループオーナー',
  name       VARCHAR(100) NOT NULL COMMENT 'グループ名',
  created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '作成日時',
  CONSTRAINT fk_groups_owner FOREIGN KEY (owner_id) REFERENCES members (id)
) COMMENT='読書グループ';books、group_books、reviewsを含めて5テーブル。一見、文句のつけようがありません。これをWorksCove ERDのSQLスキーマ読み込みに貼り付けると、リレーション線までつながった図がすぐに出来上がります。テキストでは見えなかった構造が目に入る瞬間です。描かれたリレーション線の記号が読めないときは、ER図の記号まとめが参考になります。取り込みの手順そのものはSQLからER図を自動生成するで画面付きで確認できます。
本当に大事なステップ: AI成果物の検証
AIが作るスキーマには似た傾向があります。エンティティと基本的なリレーションは早く整理できますが、運用ルールやDBMS固有の条件は抜けやすい部分です。
上の読書会スキーマを自動検証にかけた結果がこれです。
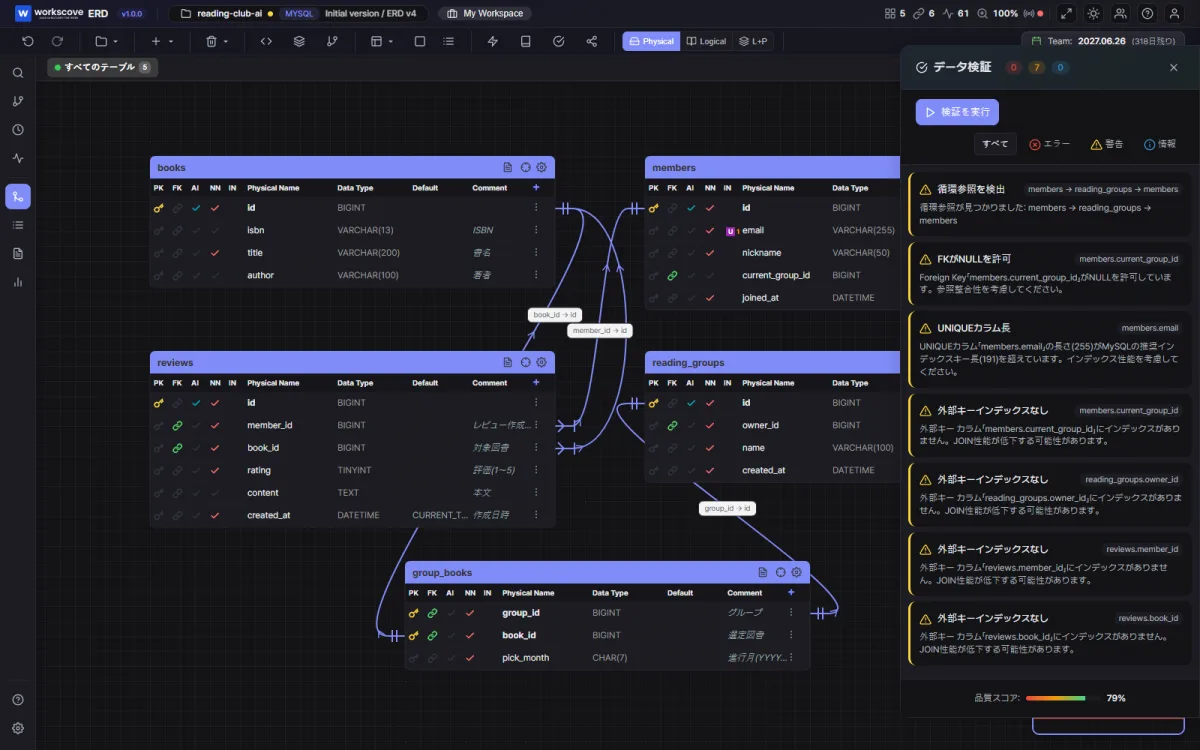
警告は7件です。ただし、警告がそのままエラーを意味するわけではありません。対象DBMSと実際のDDLを見て個別に判断します。
循環参照。 members.current_group_id がreading_groupsを指し、reading_groups.owner_id がmembersを指しています。この例では current_group_id がNULL許可なので、会員を作り、グループを作ったあとで会員を更新すれば登録できます。本当の不足は「会員が複数のグループに参加できる」という要件を表すgroup_membersテーブルです。現在のグループを別カラムに保存するかは、業務ルールと更新時の整合性を見て決めます。
FKインデックスの確認。 この例の対象であるMySQL InnoDBは、FKに必要なインデックスがなければ参照元カラム側へ自動作成します。そのため、DDLにINDEX句がないだけで欠落とは断定できません。PostgreSQLのようにFK宣言だけでは参照元側のインデックスを作らないDBMSもあるので、対象DBMSの実際のインデックスとクエリの使い方を確認します。
UNIQUEカラムの長さ。 「utf8mb4のインデックスは191文字まで」という制限は、キー上限が767バイトだった古いInnoDB行フォーマットに由来します。現在の既定であるDYNAMIC行フォーマットは3,072バイトまで使えるため、最大1,020バイトの VARCHAR(255) にUNIQUEインデックスを作成できます。サーバーのバージョンと行フォーマットを確認せず、一律に191文字へ縮めるのも正しい検証ではありません。
この3つのほかにも、AIスキーマを受け取り続ける中で繰り返し出会ったパターンがあります。
- 要件にない制約を勝手に決めています。 評価カラムを
TINYINTにするのは良いとして1〜5の範囲制限は抜けている、逆に頼んでいないCHECK制約が付いている、という具合です。自分が下していない決定がいつの間にか入り込んでいるので、1行ずつ読む必要があります。 - 似たカラムの型がテーブルごとにばらばらです。 あるテーブルの名前カラムは
VARCHAR(50)、別のテーブルではVARCHAR(100)。人間のチームなら規約で揃う部分ですが、AIはテーブル単位で生成するため全体の一貫性が弱いのです。 - 削除ポリシーが丸ごと抜けています。 このMySQLの例ではON DELETEを省略するとRESTRICTと同じ拒否動作になります。ほかのDBMSでは既定をNO ACTIONと呼び、細かな挙動が異なることもあります。RESTRICTを共通の既定値とせず、対象DBMSで親を削除したときの動作を明示する必要があります。
こうした項目を目視で全部拾うのは大変です。WorksCove ERDのデータ検証は、循環参照、インデックス欠落、予約語の使用、型の妥当性など25項目を自動で点検し、品質スコアとして要約してくれます。AIに設計を任せるほど、この検証ステップの価値は上がります。たたき台を作るのはAIで速くなりましたが、そのたたき台を信じていいか確かめるのは、依然として人とツールの仕事だからです。
検証の警告をAIに返す
検証で出た警告をAIに戻すと、ループが完成します。実際に上の循環参照の警告をそのまま貼って、こう頼みました。
このスキーマでは members.current_group_id と reading_groups の間に
循環参照があるそうです。current_group_id カラムをなくして、
参加履歴を別テーブルに分ける形で設計し直してください。
返ってきた修正案がこれです。
CREATE TABLE group_members (
  group_id  BIGINT NOT NULL COMMENT 'グループ',
  member_id BIGINT NOT NULL COMMENT '会員',
  joined_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '参加日時',
  PRIMARY KEY (group_id, member_id),
  CONSTRAINT fk_gm_group  FOREIGN KEY (group_id)  REFERENCES reading_groups (id),
  CONSTRAINT fk_gm_member FOREIGN KEY (member_id) REFERENCES members (id)
) COMMENT='グループ参加履歴';
循環が消えただけでなく、「会員は複数のグループに参加できるのか」という、元のスキーマが曖昧にしていた問いにも答えが生まれました。修正版DDLを取り込み直して検証をもう一度回すまで、数分で済みます。設計 → 検証 → 修正の反復が、人間同士でやるよりはるかに速く回ります。
Mermaidで受け取りたい場合
READMEやドキュメントに埋め込む図が目的なら、Mermaidでもらうのも手です。
erDiagram
  MEMBERS ||--o{ REVIEWS : "作成"
  BOOKS   ||--o{ REVIEWS : "対象"
  READING_GROUPS ||--o{ GROUP_BOOKS : "選定"
Markdownの中でそのままレンダリングされるので、軽く共有する分には十分です。ただ、型・インデックス・コメントといった情報は載せにくく、ここから実際のDBに行くには結局DDLを作り直すことになります。だから順番を逆にするのがおすすめです。先にDDLでもらっておけば、Mermaidが必要になったときにDDLから変換すればいい。逆方向は情報が足りないのでできません。
既存のDBがあるときのプロンプト
新規サービスの設計だけでなく、すでに動いているDBにもAIは使えます。このときは現行スキーマを材料として渡すのが肝心です。
新機能のテーブル設計。 現行スキーマのDDLを貼って「この構造にクーポン機能を足すならどんなテーブルが要る?既存の命名規則に合わせて」と聞けば、snake_caseでも接頭辞でも、手元の規約に沿った提案が返ってきます。スキーマなしで聞いたときとは品質がまるで違います。
既存構造のレビュー。 「このスキーマでデータがたまったとき問題になる箇所を挙げて」と聞けば、正規化やインデックス観点の意見が得られます。ただしあくまで意見なので、先ほどの自動検証と併用してバランスを取ってください。
現行スキーマのDDLの取り出し方が分からなければ、SQLからER図を自動生成するのステップ1にDBMS別のコマンドを集めてあります。mysqldump 1行で済みます。
まとめ: AIとの役割分担
AIに任せて良い仕事と、人が押さえるべき仕事を分けるとこうなります。
- AIに:要件からたたき台スキーマを出す、検証の警告を反映して直す、既存スキーマへの新機能テーブルを提案してもらう
- 人とツールが:図にして構造を確認する、自動検証で欠陥を拾う、業務ルール(削除ポリシー、NULL許容)が実際の要件に合うか判断する
設計の基本手順はER図の書き方で、エンティティとリレーションの決め方から確認できます。AIはたたき台を早く作れますが、結果の確認と修正には同じ基礎知識が必要です。
よくある質問
AIが設計したスキーマをそのまま使ってもいいですか?
たたき台としては優秀ですが、そのまま本番に載せるのはおすすめしません。リレーションの向きや正規化はよく出来ている一方、循環参照・インデックス欠落・型の選択といった運用で問題になる箇所をよく見落とします。図にして目で確認し、自動検証を一度回してから使うのが安全です。
どのAIがER図をいちばんうまく作れますか?
最近の対話型AIなら、この規模のスキーマ設計はどれもおおむねこなします。モデル選びよりも、要件をどれだけ具体的に書くか、出力形式をDDLに固定するか、受け取った結果を検証するかのほうが、品質をはるかに大きく左右します。
画像やMermaidで受け取ってはだめですか?
ドキュメントに埋め込む用途ならMermaidも良い選択です。ただ、画像とMermaidは受け取ったあとの編集や定義書への接続が難しいです。DDLで受け取れば図のツールにもDBにもドキュメントにもつながるので、既定はDDLにしておくのが応用が利きます。
既存のDBがある場合にもAIの出番はありますか?
新機能のテーブル追加設計や、既存構造のレビューに使えます。現行スキーマのDDLを貼ったうえで「この構造にクーポン機能を足すならどんなテーブルが要る?既存の命名規則に合わせて」と聞けば、手元の規約に沿った提案が返ってきます。