테이블 명세서에는 통일된 표준 양식이 없지만, 컬럼명(물리/논리), 자료형과 길이, NULL 허용 여부, 기본값, 키와 제약 조건, 설명은 대부분의 검수 과정에서 확인합니다.
게시판 테이블 예제로 각 항목을 채우고, 수작업 명세서에서 자주 어긋나는 부분을 확인하겠습니다. 같은 정보를 DDL에서 자동 생성하는 방법도 뒤에서 이어집니다.
명세서에 꼭 들어가는 항목
명세서는 두 부분으로 나뉩니다. 테이블 자체에 대한 요약과, 컬럼 하나하나의 정의입니다.
테이블 요약에는 물리명(members), 논리명(회원), 테이블 설명, 그리고 필요하면 문자셋 정도가 들어갑니다. 작성자·수정일 칸을 두는 양식도 많지만, 실제 갱신 절차가 없으면 오래된 값이 남기 쉽습니다.
컬럼 정의가 본체입니다. 검수자가 실제로 보는 항목은 이렇습니다.
- 컬럼명 (물리명과 논리명)
- 자료형과 길이:
VARCHAR(255)처럼 길이까지 - NULL 허용 여부
- 기본값
- 키·제약: PK, FK, UNIQUE, 인덱스 여부
- 설명: 이 컬럼이 왜 있는지 한 줄
항목마다 검수자가 보는 포인트가 조금씩 다릅니다. NULL 허용은 단순한 기술 속성이 아니라 업무 규칙의 기록입니다. "전화번호는 없어도 되는가"라는 질문의 답이 이 칸에 남습니다. 기본값은 애플리케이션이 값을 생략했을 때 DB가 넣어 줄 값을 보여줍니다. 이 칸이 비어 있다는 건 DB 기본값이 없다는 뜻일 뿐입니다. NULL 허용 컬럼을 생략하면 NULL이 들어갈 수 있고, NOT NULL 컬럼은 값을 직접 넣지 않으면 오류가 날 수 있으므로 NULL 칸과 함께 읽어야 합니다. 키 칸은 PK·FK·UK(UNIQUE)·IX(인덱스) 정도의 약어로 통일해 두면 표가 깔끔해집니다. NULL 허용과 자료형을 어떤 기준으로 정하는지는 DB 테이블 설계 체크리스트에 항목별로 정리해 두었습니다.
여기에 테이블 수준의 부록으로 인덱스 목록과 FK 관계(어느 테이블의 어느 컬럼을 참조하는지, 삭제 시 동작은 무엇인지)를 붙이면 완성입니다. 부록 예시는 아래 양식에서 함께 보겠습니다. FK 관계를 다이어그램의 기호로 읽는 법이 궁금하면 ERD 표기법 총정리가 있습니다.
바로 쓰는 양식: 게시판 DB 예시
ERD 그리는 법에서 설계한 게시판 DB로 양식을 채워 보겠습니다. 먼저 가장 단순한 members 테이블입니다.
테이블: members (회원): 서비스 가입 계정
| No | 컬럼명 | 논리명 | 자료형 | NULL | 기본값 | 키 | 설명 |
|---|---|---|---|---|---|---|---|
| 1 | id | 회원 번호 | BIGINT | N | AUTO_INCREMENT | PK | 대리키 |
| 2 | 이메일 | VARCHAR(255) | N | — | UK | 로그인 계정, 변경 가능 | |
| 3 | nickname | 닉네임 | VARCHAR(50) | N | — | — | 화면 표시용 |
| 4 | created_at | 가입 시각 | DATETIME | N | CURRENT_TIMESTAMP | — | 앱 미입력 시 DB가 기록 |
FK가 있는 테이블은 한 줄이 더 필요합니다. posts를 같은 양식으로 옮기면 이렇게 됩니다.
테이블: posts (게시글): 회원이 카테고리에 작성하는 글
| No | 컬럼명 | 논리명 | 자료형 | NULL | 기본값 | 키 | 설명 |
|---|---|---|---|---|---|---|---|
| 1 | id | 게시글 번호 | BIGINT | N | AUTO_INCREMENT | PK | 대리키 |
| 2 | member_id | 작성 회원 | BIGINT | N | — | FK | members.id 참조 |
| 3 | category_id | 소속 카테고리 | INT | N | — | FK | categories.id 참조 |
| 4 | title | 제목 | VARCHAR(200) | N | — | — | |
| 5 | content | 본문 | MEDIUMTEXT | N | — | — | 장문 대비 |
| 6 | created_at | 작성 시각 | DATETIME | N | CURRENT_TIMESTAMP | — |
그리고 테이블 아래에 부록 두 개를 붙입니다. 검수자가 관계와 성능을 확인하는 곳이 여기입니다.
외래키
| 이름 | 컬럼 | 참조 대상 | 삭제 시 |
|---|---|---|---|
| fk_posts_member | member_id | members.id | RESTRICT |
| fk_posts_category | category_id | categories.id | RESTRICT |
인덱스
| 이름 | 컬럼 | 유형 |
|---|---|---|
| pk_posts | id | PK |
| uq_members_email | UNIQUE |
이 표들을 그대로 엑셀에 붙여 넣으면 양식이 됩니다. 시트 하나에 테이블 하나, 표지 시트에는 테이블 목록과 문서 기준일(어느 시점의 스키마인지)을 적습니다. 이 구성이 검수받을 때 가장 무난합니다.
빈 엑셀 파일부터 시작하려면 테이블 명세서 양식 무료 다운로드를 사용할 수 있습니다. 작성 예시와 빈 시트가 함께 들어 있습니다.
논리명과 설명 칸을 비워둔 명세서가 의외로 많습니다. 물리명과 자료형은 DB에서 언제든 다시 뽑을 수 있지만, "이 컬럼이 왜 있는지"는 문서에만 남습니다. 명세서를 굳이 만드는 이유가 사실 그 칸에 있습니다.
검수에서 자주 지적받는 다섯 가지
명세서를 받아 보는 입장에서 어떤 지적이 나오는지 알면, 처음부터 그 지점을 피해서 쓸 수 있습니다. 자주 나오는 순서대로 다섯 가지입니다.
1. 논리명이 화면 용어와 따로 노는 것. 화면에서는 "별명"인데 명세서에는 "닉네임"으로 적혀 있으면, 검수자는 어느 쪽이 맞는지부터 물어봅니다. 논리명은 기획서·화면에서 쓰는 용어와 맞추는 게 원칙입니다.
2. 자료형과 실제 데이터의 불일치. VARCHAR(50)이라고 적혀 있는데 실제 데이터에 60자짜리가 들어 있는 경우입니다. 문서를 먼저 쓰고 DB를 나중에 고친 흔적이라, 신뢰도 전체가 의심받는 계기가 됩니다.
3. FK 표기만 있고 참조 대상이 없는 것. "FK"라고만 적으면 어느 테이블의 어느 컬럼을 참조하는지, 부모가 지워질 때 어떻게 되는지 알 수 없습니다. 참조 대상과 삭제 규칙까지가 FK 정보입니다.
4. 어느 시점의 스키마인지 알 수 없는 것. 기준일 없는 명세서는 "지금 DB와 같은가"라는 질문에 답할 수 없습니다. 표지에 기준일 한 줄이면 해결되는데 의외로 빠져 있는 문서가 많습니다.
5. 실제 DB와 대조하면 다른 것. 영향이 크고 자주 확인되는 항목입니다. 수작업으로 두 자료를 함께 갱신하는 구조에서는 개인의 확인만으로 계속 일치시키기 어렵습니다.
다섯 가지 중 2·3·5번은 뒤에서 다룰 자동 생성으로 원천 차단됩니다. 문서가 스키마에서 나오면 스키마와 다를 방법이 없으니까요.
직접 작성할 때의 함정: 문서가 스키마를 따라가지 못한다
명세서를 한 번 작성하는 것 자체는 어렵지 않습니다. 정작 힘든 건 그다음부터입니다.
스키마는 개발이 진행되는 내내 바뀝니다. 컬럼이 추가되고, 타입이 늘어나고, 인덱스가 생깁니다. 그때마다 엑셀을 같이 고치는 팀은 드뭅니다. 몇 주 지나면 명세서가 실제 DB와 어긋나기 시작하고, 그걸 한 번 확인한 뒤로는 아무도 명세서를 보지 않게 됩니다.
파일 관리도 함정입니다. 명세서_최종.xlsx, 명세서_최종_v2.xlsx, 명세서_진짜최종.xlsx. 웃자고 하는 얘기가 아니라, 어느 파일이 최신인지 아무도 확신하지 못하는 상태는 명세서가 어긋나 있는 상태만큼 위험합니다.
SI 현장이라면 부담이 하나 더 있습니다. 명세서는 계약 산출물이라 검수 대상이고, 검수는 코드보다 문서를 먼저 봅니다. 납품 직전에 명세서와 실제 스키마를 한 줄씩 대조해 본 분이라면, 그 작업을 다시 하고 싶지 않다는 데 동의하실 겁니다.
SQL에서 자동 생성하기
테이블 명세서를 자동 생성하려면 방향을 바꿔야 합니다. 명세서의 원본은 문서가 아니라 스키마입니다. DDL에는 컬럼명, 자료형, NULL, 기본값, 키까지 명세서 필수 항목의 대부분이 이미 들어 있습니다. 없는 건 논리명과 설명뿐인데, 이것도 DDL의 COMMENT로 채울 수 있습니다.
CREATE TABLE members (
  id         BIGINT AUTO_INCREMENT PRIMARY KEY COMMENT '회원 번호',
  email      VARCHAR(255) NOT NULL UNIQUE COMMENT '이메일: 로그인 계정',
  nickname   VARCHAR(50)  NOT NULL COMMENT '닉네임: 화면 표시용',
  created_at DATETIME     NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '가입 시각'
) COMMENT '회원';
이렇게 코멘트를 단 DDL을 WorksCove ERD에 붙여넣으면 다이어그램과 함께 위 양식 그대로의 테이블 명세서가 만들어지고, 검수용 엑셀로도 바로 내보낼 수 있습니다. 운영 중인 DB라면 DDL을 뽑을 필요도 없이 리버스 엔지니어링으로 직접 가져오면 되고, 접근이 제한된 서버라면 SSH 터널을 거쳐 연결하는 방법도 있습니다.
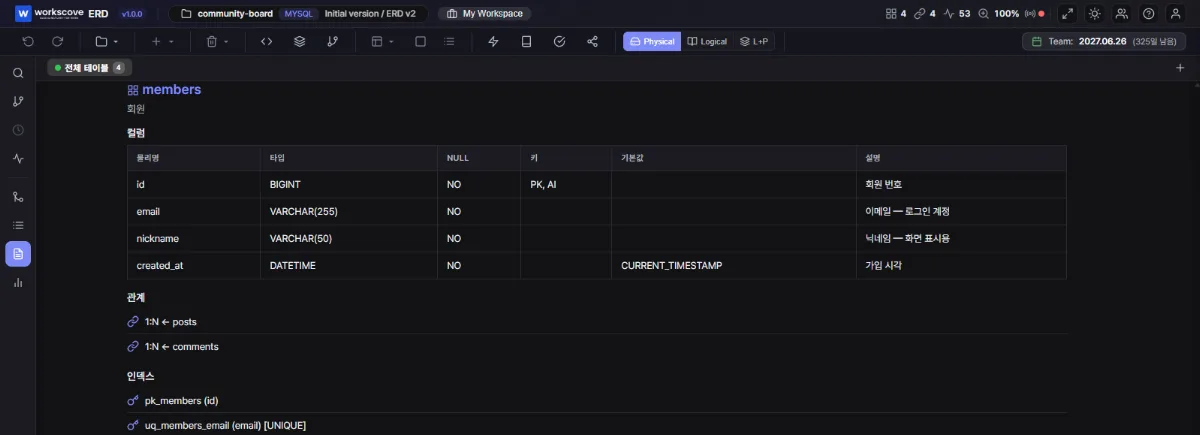
DDL에 적어둔 COMMENT '회원'이 테이블 논리명으로, 컬럼 코멘트가 설명 칸으로 그대로 들어간 것을 볼 수 있습니다. 관계와 인덱스는 스키마에서 읽어낸 것이라 따로 적을 필요조차 없습니다.
코멘트를 다는 팀 규칙 세 가지
자동 생성의 품질은 코멘트의 품질에 달려 있습니다. 팀에서 이 세 가지만 정해두면 명세서가 눈에 띄게 좋아집니다.
- 형식을 통일합니다. "논리명: 부가 설명" 한 가지 형태로 맞추면, 도구가 논리명과 설명을 나눠 담기도 좋고 사람이 읽기에도 일관됩니다.
- 코드값은 반드시 나열합니다.
status TINYINT COMMENT '상태: 1=활성, 2=휴면, 3=탈퇴'같은 식입니다. 이 한 줄이 없으면 코드값의 의미는 담당자의 기억에만 남게 됩니다. - 숫자에는 단위를 밝힙니다.
amount BIGINT COMMENT '결제 금액(원)'처럼요. 원인지 달러인지, MB인지 GB인지는 코멘트 없이는 알 방법이 없습니다.
이미 코멘트 없이 운영 중인 DB라면 전체를 한 번에 달려고 하지 않아도 됩니다. 새로 만드는 테이블과 수정하는 테이블부터 적용하고, 기존 것은 핵심 도메인(회원·주문처럼 모두가 보는 테이블)부터 채워 나가는 쪽이 현실적입니다.
갱신은 수정이 아니라 재생성
자동 생성은 스키마가 바뀐 뒤에 효과가 큽니다. 명세서를 직접 고치는 대신 다시 생성하므로, 최신 스키마와 다른 파일이 남을 가능성이 줄어듭니다. 제출 형식은 엑셀로 유지하면서 생성 작업만 자동화할 수 있습니다.
앞에서 본 검수 항목 중 자료형 불일치(2), FK 정보 누락(3), 실DB와의 불일치(5)는 자동 생성으로 줄일 수 있습니다. 논리명을 화면 용어와 맞추는 일(1)과 표지에 기준일을 적는 일(4)은 별도의 작성 규칙으로 관리해야 합니다.
자주 묻는 질문
테이블 명세서와 테이블 정의서는 다른 문서인가요?
현장에 따라 부르는 이름이 다를 뿐 사실상 같은 문서입니다. 명세서·정의서·스키마 정의서 모두 테이블의 컬럼 구성과 제약 조건을 정리한 산출물을 가리킵니다. 발주처나 팀이 쓰는 용어를 따르면 됩니다.
명세서는 꼭 엑셀로 만들어야 하나요?
표준이라기보다 관행입니다. 검수·납품 과정에서 엑셀을 요구하는 곳이 많아 최종 산출물은 엑셀인 경우가 흔하지만, 원본까지 엑셀로 관리할 이유는 없습니다. 스키마에서 자동 생성하고 제출할 때만 엑셀로 내보내는 쪽이 안전합니다.
컬럼 코멘트는 어디까지 자세히 써야 하나요?
논리명 하나, 필요하면 부가 설명 한 줄이면 충분합니다. 다만 코드값을 담는 컬럼은 값의 의미를 반드시 나열하고(1=활성, 2=휴면처럼), 숫자 컬럼은 단위를 밝혀 주세요. 문장형 설명을 길게 쓰는 것보다 이 두 가지를 지키는 쪽이 문서의 쓸모를 훨씬 크게 만듭니다.
이미 운영 중인 DB의 명세서를 만들어야 하는데 처음부터 써야 하나요?
쓸 필요 없습니다. DDL을 내보내 ERD 도구에 붙여넣거나 DB에 직접 연결해 가져오면, 컬럼·자료형·제약·코멘트가 그대로 명세서로 정리됩니다. 처음부터 타이핑하는 건 오타만 늘립니다.
처음에는 필요한 항목을 갖춘 양식으로 기준을 잡고, 반복 갱신이 시작되면 스키마를 원본으로 삼아 문서를 생성하는 편이 안전합니다.
다음 주제로는 테이블을 어디까지 쪼갤지 정하는 정규화가 자연스럽게 이어집니다. 게시판 예제를 그대로 들고 가서 살펴볼 예정입니다.