テーブル定義書に一つの標準様式はありません。ただし、物理名・論理名、データ型と桁数、NULL許可、デフォルト値、キーと制約、説明は多くの検収工程で確認されます。
掲示板テーブルで各項目を埋め、手作業の定義書で起きやすい不一致を確認します。後半では同じテーブル定義書をDDLから自動生成します。
定義書に必ず入る項目
定義書は2つの部分に分かれます。テーブル自体の要約と、カラム一つひとつの定義です。
テーブル要約には物理名(members)、論理名(会員)、テーブルの説明、必要なら文字セットが入ります。作成者・更新日の欄を設けた様式も多いのですが、後述するとおり、この欄が最後まで維持されている現場をほとんど見たことがありません。
カラム定義が本体です。検収する側が実際に見る項目はこうです。
- カラム名(物理名と論理名)
- データ型と桁数:
VARCHAR(255)のように桁数まで - NULL許可
- デフォルト値
- キー・制約:PK、FK、UNIQUE、インデックスの有無
- 説明:このカラムがなぜ必要なのかを一行で
それぞれの項目には、見た目以上の意味があります。NULL許可は単なる技術属性ではなく、業務ルールの記録です——「電話番号がない会員は存在してよいか」という問いの答えがこの欄に残ります。デフォルト値は、INSERTでカラムを省略したときにDBが補う値を示します。空欄はDB側のデフォルト値がないという意味にすぎません。NULL許可カラムなら省略時にNULLが入り得ますが、NOT NULLカラムならエラーになることがあるため、NULL許可欄とあわせて読みます。キー欄はPK・FK・UK(UNIQUE)・IX(インデックス)程度の略号に統一すると表が読みやすくなります。NULL許可やデータ型をどの基準で決めるのかは、テーブル設計チェックリストに項目ごとにまとめています。
これにテーブル単位の付録としてインデックス一覧と外部キー(どのテーブルのどのカラムを参照するか、削除時の挙動は何か)を添えれば完成です。付録の実例は次のテンプレートで一緒に見ていきます。FKのリレーションを図の記号として読む方法はER図の記号まとめで扱っています。
そのまま使えるテンプレート: 掲示板DBの例
ER図の書き方で設計した掲示板DBで様式を埋めていきます。まずいちばん単純な members テーブルです。
テーブル: members(会員): サービス登録アカウント
| No | カラム名 | 論理名 | データ型 | NULL | デフォルト | キー | 説明 |
|---|---|---|---|---|---|---|---|
| 1 | id | 会員番号 | BIGINT | N | AUTO_INCREMENT | PK | サロゲートキー |
| 2 | メールアドレス | VARCHAR(255) | N | — | UK | ログインID、変更あり | |
| 3 | nickname | ニックネーム | VARCHAR(50) | N | — | — | 画面表示用 |
| 4 | created_at | 登録日時 | DATETIME | N | CURRENT_TIMESTAMP | — | アプリ未設定時はDBが記録 |
外部キーを持つテーブルには、FKごとにもう一段の情報が要ります。posts を同じ様式に落とすとこうなります。
テーブル: posts(投稿): 会員がカテゴリに書く記事
| No | カラム名 | 論理名 | データ型 | NULL | デフォルト | キー | 説明 |
|---|---|---|---|---|---|---|---|
| 1 | id | 投稿番号 | BIGINT | N | AUTO_INCREMENT | PK | サロゲートキー |
| 2 | member_id | 投稿者 | BIGINT | N | — | FK | members.id を参照 |
| 3 | category_id | 所属カテゴリ | INT | N | — | FK | categories.id を参照 |
| 4 | title | タイトル | VARCHAR(200) | N | — | — | |
| 5 | content | 本文 | MEDIUMTEXT | N | — | — | 長文対応 |
| 6 | created_at | 作成日時 | DATETIME | N | CURRENT_TIMESTAMP | — |
そしてテーブルの下に付録を2つ添えます。検収する側がリレーションと性能を確認するのはここです。
外部キー
| 名前 | カラム | 参照先 | 削除時 |
|---|---|---|---|
| fk_posts_member | member_id | members.id | RESTRICT |
| fk_posts_category | category_id | categories.id | RESTRICT |
インデックス
| 名前 | カラム | 種類 |
|---|---|---|
| pk_posts | id | PK |
| uq_members_email | UNIQUE |
この表をそのままExcelに貼れば様式になります。1シートに1テーブル、表紙シートにはテーブル一覧と基準日(どの時点のスキーマか)を書きます。この構成が検収時に最も無難です。
ひとつ補足すると、論理名と説明の欄が空のまま提出される定義書が意外と多くあります。物理名とデータ型はDBからいつでも取り出せますが、「このカラムがなぜあるのか」は文書にしか残りません。定義書をわざわざ作る理由は、実はその欄にあります。
検収でよく指摘される5つのポイント
受け取る側がどこを見るのかを知っておくと、最初からその地点を避けて書けます。よく出る順に5つです。
1. 論理名が画面の用語と食い違っている。 画面では「ハンドル名」なのに定義書では「ニックネーム」と書かれていると、検収者の最初の質問は「どちらが正しいのか」になります。論理名は仕様書・画面の用語に合わせるのが原則です。
2. データ型が実データと合っていない。 VARCHAR(50) と書いてあるのに実データに60文字が入っているケースです。文書を先に書いてDBを後から直した痕跡なので、文書全体の信頼が疑われるきっかけになります。
3. 「FK」とだけ書かれて参照先がない。 FKの印だけでは、どのテーブルのどのカラムを参照するのか、親が消えたらどうなるのかが分かりません。参照先と削除ルールまでがFKの情報です。
4. どの時点のスキーマか分からない。 基準日のない定義書は「今のDBと同じか」という問いに答えられません。表紙に一行あれば済むのに、抜けている文書が意外と多いのです。
5. 実際のDBと突き合わせると違う。 影響が大きく、検収でも確認されやすい項目です。二つの情報を手作業で更新する運用では、個人の確認だけで長期間一致させるのは困難です。
5つのうち2・3・5は、後で扱う自動生成によって発生を減らせます。スキーマから文書を作り直せば、古い型や参照先が残りにくくなります。
手作業の落とし穴: 文書がスキーマに追いつかない
定義書を一度書くこと自体は難しくありません。大変なのはその後です。
開発中のスキーマには、カラム追加、型変更、インデックス追加が続きます。Excelの更新が一度でも漏れると、定義書と実際のDBに差が生まれ、その後のレビューで資料を信用しにくくなります。
ファイル管理も同じです。定義書_最終.xlsx、定義書_最終_v2.xlsx、定義書_本当に最終.xlsx。笑い話ではなく、どれが最新か誰も確信できない状態は、定義書がずれている状態と同じくらい危険です。
受託開発なら、なおさらです。定義書は契約上の成果物なので検収対象であり、検収はコードより先に文書を見ます。納品直前に定義書と実際のスキーマを一行ずつ突き合わせた経験がある方なら、その作業を二度としたくないという点に同意いただけるはずです。
DDLから自動生成する
解決策は向きを変えることです。定義書の原本は文書ではなくスキーマです。 DDLにはカラム名、データ型、NULL、デフォルト値、キー——必須項目のほとんどがすでに入っています。足りないのは論理名と説明だけで、それもDDLのCOMMENTで埋められます。
CREATE TABLE members (
  id         BIGINT AUTO_INCREMENT PRIMARY KEY COMMENT '会員番号',
  email      VARCHAR(255) NOT NULL UNIQUE COMMENT 'メールアドレス:ログインID',
  nickname   VARCHAR(50)  NOT NULL COMMENT 'ニックネーム:画面表示用',
  created_at DATETIME     NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '登録日時'
) COMMENT '会員';
このようにコメントを付けたDDLを WorksCove ERD に貼り付けると、ダイアグラムと一緒に上の様式どおりのテーブル定義書が生成され、検収用のExcelにもそのまま出力できます。稼働中のDBなら、DDLを取り出すまでもなくリバースエンジニアリングで直接取り込めます。サーバーに直接届かない環境なら、SSHトンネル経由で接続する方法もあります。
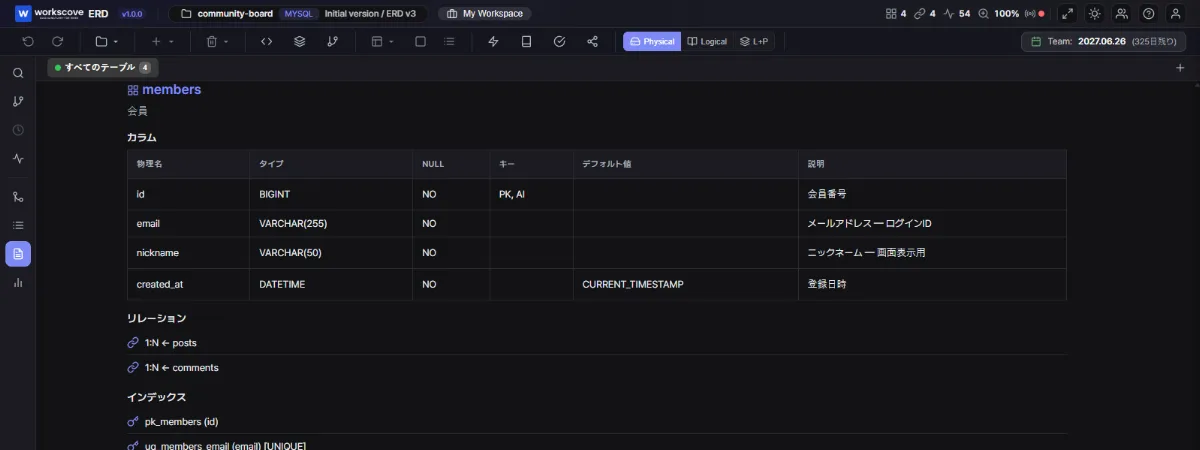
DDLに書いた COMMENT '会員' がテーブルの論理名に、カラムのコメントが説明欄にそのまま入っているのが分かります。リレーションとインデックスはスキーマから読み取ったものなので、書く必要すらありません。
チームで決めておきたいコメントの規約3つ
自動生成の品質は、コメントの品質で決まります。この3つだけ決めておくと定義書が目に見えて良くなります。
- 形式を統一する。 「論理名:補足説明」というひとつの形に揃えると、ツールが論理名と説明を分けて収めやすく、人が読んでも一貫します。
- コード値は必ず列挙する。
status TINYINT COMMENT '状態: 1=有効, 2=休眠, 3=退会'。この一行がないと、コード値の意味は担当者の記憶の中にしか存在しなくなります。 - 数値には単位を書く。
amount BIGINT COMMENT '決済金額(円)'のように。円なのかドルなのか、MBなのかGBなのかは、コメントなしでは知りようがありません。
コメントなしで運用してきたDBなら、全部を一度に付けようとしなくて大丈夫です。新規・変更するテーブルから適用し、既存分は中核ドメイン(会員・注文のように皆が見るテーブル)から埋めていくのが現実的です。
更新は「直す」のではなく「作り直す」
自動生成はスキーマ変更後の更新で効果を発揮します。定義書を直接修正せず再生成するため、古い内容が残る可能性を減らせます。提出形式をExcelのまま維持し、作成工程だけを自動化できます。
検収項目のうち、型の不一致(2)、FK参照先の欠落(3)、実DBとの食い違い(5)は自動生成で減らせます。論理名を画面用語に合わせること(1)と表紙に基準日を書くこと(4)は、別の作成ルールとして管理します。
よくある質問
テーブル定義書とデータディクショナリは別の文書ですか?
重なる部分が多い文書です。テーブル定義書は各テーブルのカラム構成と制約をまとめたもの、データディクショナリはシステム全体の用語まで含むより広い文書を指すことが多いですが、実務ではほぼ同じ意味で使われます。現場で使われている呼び方に合わせれば問題ありません。
定義書は必ずExcelで作らないといけませんか?
標準というより慣習です。検収や納品でExcelを求められる現場が多いため最終成果物はExcelになりがちですが、原本までExcelで管理する理由はありません。スキーマから自動生成し、提出するときだけExcelに出力するほうが安全です。
カラムコメントはどこまで詳しく書くべきですか?
論理名ひとつ、必要なら補足を一言添える程度で十分です。ただし2つだけは必須です。コード値を持つカラムは値の意味を必ず列挙すること(1=有効、2=休眠のように)、数値カラムは単位を明記すること。長い説明文よりこの2つの習慣のほうが、文書の実用性をはるかに高めます。
すでに稼働中のDBの定義書を作る場合、一から書く必要がありますか?
必要ありません。DDLをエクスポートしてER図ツールに貼り付けるか、リバースエンジニアリング対応のツールならDBに直接接続して取り込みます。カラム・型・制約・コメントがそのまま定義書になります。手打ちは誤字を増やすだけです。
必要な項目はテンプレートで揃え、更新が繰り返される段階ではスキーマを原本として文書を生成するほうが安全です。
次のテーマとしては、テーブルをどこまで分割するかを決める正規化が自然につながります。掲示板の例をそのまま使って見ていく予定です。