データベースの正規化は、実務では更新時の不整合を防ぐために使います。掲示板とECサイトの例で第1・第2・第3正規形が防ぐ問題を確認し、非正規化を選ぶ条件まで整理します。
会員の住所を会員・注文・配送の3テーブルに保存し、引っ越し後に1か所だけ更新したとします。同じ会員に異なる住所が残り、どれを正とするか判断できません。これが更新時の不整合(更新異常)で、正規化は重複する更新箇所を構造から減らします。
ひと目でわかる:第1〜第3正規形が防ぐトラブル
3つの正規形の違いを先に表で押さえておくと、下の例を早く身につけられます。
| 正規形 | 捕まえる構造 | 代表的な症状 |
|---|---|---|
| 第1正規形(1NF) | 1マスに複数の値 | カンマでつないだタグを検索・結合できない |
| 第2正規形(2NF) | 複合キーの一部にだけ従属するカラム | 注文明細ごとに商品名がコピーされ修正が大仕事になる |
| 第3正規形(3NF) | キー以外のカラムに従属するカラム | 郵便番号を直すと市区町村も直すことになる |
ここから、違反のDDLと直したDDLを並べてひとつずつ見ていきます。
第1正規形(1NF):カンマ区切りカラムの例
いちばんよく見る違反からです。投稿にタグを付けたいけれどテーブルを増やしたくなくて、こう作ってしまった場合です。
-- 1NF違反:1カラムに複数の値
CREATE TABLE posts (
  id    BIGINT AUTO_INCREMENT PRIMARY KEY,
  title VARCHAR(200) NOT NULL,
  tags  VARCHAR(255) NULL COMMENT 'タグ:mysql,er図,正規化 のようにカンマで'
);最初は問題なく動きます。困るのは「er図タグが付いた投稿一覧」が要るようになった瞬間からです。LIKE '%er図%' の検索は別のタグまで拾い、インデックスは効かず、タグ名をひとつ変えるには文字列を全部パースして直すことになります。1マスに値が複数入った瞬間、DBはその値をデータとして扱えなくなるのです。
1NFは「すべてのマスに値はひとつ」という規則で、直し方は値ごとに行を持たせることです。
-- 1NF充足:タグを行に
CREATE TABLE tags (
  id   INT AUTO_INCREMENT PRIMARY KEY,
  name VARCHAR(50) NOT NULL UNIQUE COMMENT 'タグ名'
);

CREATE TABLE post_tags (
  post_id BIGINT NOT NULL,
  tag_id  INT    NOT NULL,
  PRIMARY KEY (post_id, tag_id),
  CONSTRAINT fk_pt_post FOREIGN KEY (post_id) REFERENCES posts (id),
  CONSTRAINT fk_pt_tag  FOREIGN KEY (tag_id)  REFERENCES tags (id)
) COMMENT='投稿タグ';
確認ポイントはひとつです。カンマ・スラッシュ・空白で値をつないだカラムはないか。あるなら、検索が必要になってから直すより、いま分けておくほうが修正の手間がずっと少なくて済みます。
第2正規形(2NF):複合キーの半分にだけ従属するカラム
2NFが問題になるのは複合主キーを使うテーブルだけです。ECサイトの注文明細テーブルで見ていきます。
-- 2NF違反:product_nameが複合キーの一部(product_id)にだけ従属
CREATE TABLE order_items (
  order_id     BIGINT NOT NULL,
  product_id   BIGINT NOT NULL,
  product_name VARCHAR(200) NOT NULL COMMENT '商品名(問題のカラム)',
  quantity     INT NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
このテーブルの主キーは(order_id, product_id)の複合キーです。ところがproduct_nameは、注文と関係なくproduct_idだけで決まる値です。結果は、同じ商品名が注文明細の数だけコピーされること。商品名を変える日には数万行をUPDATEするか、一部だけ直って同じ商品が2つの名前で残ることになります。ここではproduct_nameを商品の現在名のコピーと仮定しています。注文時に表示した商品名を残すスナップショットなら現在名とは別の事実なので、同じ部分従属の判断は当てはまりません。
部分関数従属とは
いまの状況を呼ぶ名前が部分関数従属です。難しく聞こえますが意味はそのままで、複合キーの一部だけで決まるカラムがそのテーブルに入っている状態です。product_nameはキーの半分(product_id)にだけ従属しているので部分従属で、2NFはこういうカラムを自分のキーがあるテーブルへ移しなさいという規則です。
-- 2NF充足:商品情報はproductsへ
CREATE TABLE products (
  id   BIGINT AUTO_INCREMENT PRIMARY KEY,
  name VARCHAR(200) NOT NULL COMMENT '商品名'
);

CREATE TABLE order_items (
  order_id   BIGINT NOT NULL,
  product_id BIGINT NOT NULL,
  quantity   INT NOT NULL,
  PRIMARY KEY (order_id, product_id),
  CONSTRAINT fk_oi_product FOREIGN KEY (product_id) REFERENCES products (id)
);
確認ポイント:複合キーのテーブルで「このカラム、キー全体ではなく一部だけでも決まらないか?」をカラムごとに問えば見つかります。ひとつでも当てはまれば、そのカラムの置き場所は別のテーブルです。
第3正規形(3NF):キーでないカラムに従属するカラム
3NFは複合キーがなくても引っかかります。会員テーブルに住所を入れるとよく生まれる形です。
-- 3NF違反:cityがキー(id)ではなくzip_codeに従属
CREATE TABLE members (
  id       BIGINT AUTO_INCREMENT PRIMARY KEY,
  email    VARCHAR(255) NOT NULL UNIQUE,
  zip_code CHAR(7)     NULL COMMENT '郵便番号',
  city     VARCHAR(50) NULL COMMENT '市区町村(問題のカラム)'
);
この例では、郵便番号一つが市区町村一つを決めるという業務規則を仮定します。その仮定ならcityは会員(id)ではなくzip_codeで決まります。ただし、実際の郵便制度では一つの郵便番号が複数の地域名に対応する場合があります。運用スキーマへ適用する前に、対象国の住所データでこの関数従属が本当に成り立つか確認してください。
推移的関数従属の例
この構造の名前は推移的関数従属です。idがzip_codeを決め、zip_codeがcityを決めるので、id → zip_code → cityと間接的に従属がつながった状態です。3NFはこのつながりを断って、キーでないカラム(zip_code)に従属するカラム(city)を別のテーブルへ移しなさいという規則です。
-- 3NF充足:郵便番号の情報はzip_codesへ
CREATE TABLE zip_codes (
  zip_code CHAR(7) PRIMARY KEY COMMENT '郵便番号',
  city     VARCHAR(50) NOT NULL COMMENT '市区町村'
);

CREATE TABLE members (
  id       BIGINT AUTO_INCREMENT PRIMARY KEY,
  email    VARCHAR(255) NOT NULL UNIQUE,
  zip_code CHAR(7) NULL,
  CONSTRAINT fk_members_zip FOREIGN KEY (zip_code) REFERENCES zip_codes (zip_code)
);
確認ポイント:「このカラム、主キー以外のカラムだけでも決まらないか?」。決まるなら、その別のカラムをキーに持つテーブルへ移すべきです。
BCNFから先をあまり話さない理由
教科書にはBCNF、第4正規形、第5正規形と続きますが、実務の大半は3NFで止まります。それより上が3NFと違う結果になるのは、候補キーが重なる場合や多値従属がある特殊な構造だけで、普通の業務スキーマは3NFを守れば自動的に満たしていることが多いのです。3NFまでを基礎として確実にして、その上は該当する構造に出会ったときに調べても遅くありません。
非正規化はいつやるのか:判断基準3つ
ここまで読んで「じゃあとにかく分ければいい」で終わると、半分しか学んでいないことになります。実務には、正規形を知ったうえであえて崩す選択、非正規化があります。問題は崩すこと自体ではなく根拠なく崩すことなので、設計レビューで非正規化を認めるときに見る基準は3つです。
- 計測されたボトルネックか。 「結合が多いと遅くなりそう」は根拠になりません。実際のクエリの実行計画と応答時間が問題として計測されてからの話です。推測で作った重複は、性能はそのままで事故のリスクだけ積むことになりがちです。
- 更新経路が1か所で管理されるか。 重複を作ると、2つの値を揃える責任がアプリケーションに移ります。その更新がトリガーでもバッチでもコード1か所でも、単一の経路で行われるという答えが必要です。
- 崩した事実が文書に残るか。 次の担当者が「これ重複してるけどミスかな」と整理してしまった瞬間が事故です。どのカラムがなぜ重複なのかをテーブル定義書に残すところまでが非正規化です。
よくある2つの型も区別しておく必要があります。集計カラム(投稿のコメント数のような)は、数えれば出る値を性能のために保存する典型的な非正規化なので、上の3基準を全部通す必要があります。一方、スナップショットのカラム(注文明細の注文時点単価)はそもそも非正規化ではありません。商品の現在価格と注文当時の価格は別の意味のデータで、コピーではなくその時点の事実の記録だからです。この区別が付くと、重複に見えるカラムが出てきたときの判断が速くなります。
正規化した結果を目で確かめる
正規化はテーブルを分ける作業なので、終わるとテーブル数が増えてリレーション線が生まれます。この時点で構造を目で確かめておくとよいです。上で直したDDLをそのままWorksCove ERDに貼り付けると、こう描かれます。
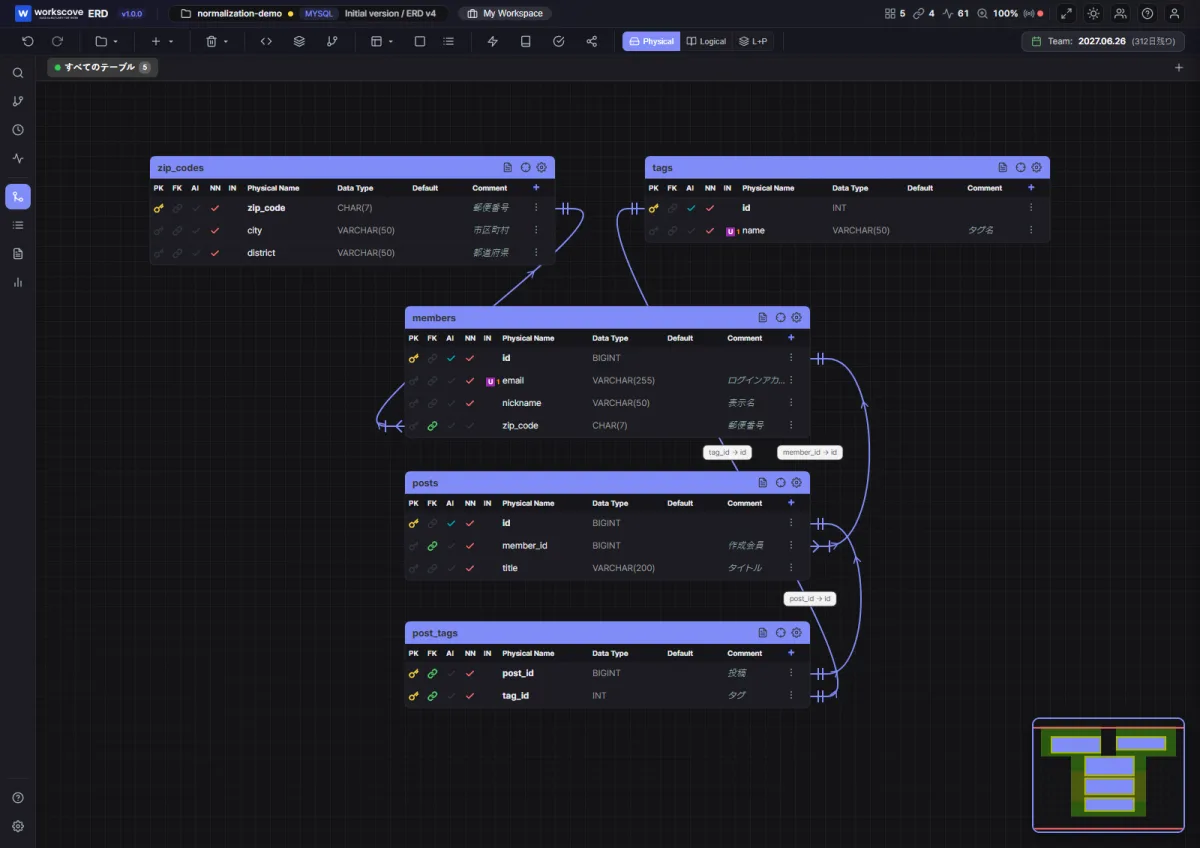
カンマ区切りだったタグがpost_tagsの中間テーブルに、会員の中にあった市区町村がzip_codesへの参照に変わった構造が、リレーション線として見えます。線の記号が読みにくければER図の記号まとめを横に置いてください。FKがリレーションのN側に正しくあるか、分けたテーブルが意図どおりつながったかの確認はER図の書き方のチェックリストがそのまま使えますし、DDLを取り出して貼り付ける流れ自体はSQLからER図を自動生成するにまとまっています。
よくある質問
正規化はどの正規形まですればよいですか?
実務の基準は第3正規形(3NF)までです。第1〜第3正規形が実務で起きるトラブルの大半を防いでくれて、その上のBCNF・第4正規形は、候補キーが重なる場合や多値従属のような特殊な構造でしか3NFと結果が変わりません。3NFを基本に置き、性能のためにあえて崩す非正規化を例外として管理するのが現実的な運用です。
注文テーブルに注文時点の価格をコピーするのは正規化違反ですか?
違反ではなく、正しい設計です。注文時点の価格と商品の現在価格は別の意味のデータで、商品の価格が変わっても過去の注文金額はそのまま残らなければなりません。同じ値の重複保存ではなくその時点の事実の記録なので、スナップショットのカラムは正規化と衝突しません。
JSONカラムに複数の値を入れるのは第1正規形違反ですか?
JSON配列だから必ず第1正規形違反とは限りません。現在のDBMSはJSONパスや配列要素にインデックスを作れますが、タグのようにほかの行と関係する値は外部キーや一意性の保証が複雑になります。設定値やログを丸ごと保存して読む用途ならJSONが実用的で、検索・結合・参照整合性が重要なら別の行へ分けるほうが適しています。
NoSQLの時代にも正規化は必要ですか?
リレーショナルDBを使う限り必要です。NoSQLが重複を許すのは正規化が間違いだからではなく、更新時の不整合の管理をアプリケーションが引き受ける代わりに読み取り性能を得る、別のやり方を選んでいるだけです。その選択の代償を理解するには、正規化が何を防いでいたのかをむしろ知っておく必要があるので、どちらを使うにせよ出発点は同じです。
正規化の基本は、1マスに値をひとつ置くこと(1NF)、非キー属性を複合キー全体に従属させること(2NF)、非キー属性同士の従属を分離すること(3NF)です。非正規化する前に、計測したボトルネック、単一の更新経路、文書化の有無を確認します。